GDA(高斯判别分析)
多个样本联合概率等于每个的乘积:
P ( Y ∣ X ) = ∏ i = 1 m P ( y i ∣ x i ) P(boldsymbol{Y}|boldsymbol{X}) = prod_{i=1}^{m} P(y_i| x_i) P(Y∣X)=i=1∏mP(yi∣xi)
高斯判别分析试图求出 y ^ = arg max y P ( x ∣ y ) P ( y ) , y ∈ { 0 , 1 } hat y={argmax}_y{P(boldsymbol x|y)P(y)} ,quad yin{0,1} y^=argmaxyP(x∣y)P(y) ,y∈{0,1}。
多元高斯分布:
有 n n n维随机向量 x = [ x 1 x 2 ⋯ x n ] T boldsymbol{x}=begin{bmatrix}x_1&x_2&cdots&x_nend{bmatrix}^T x=[x1x2⋯xn]T,存在 μ = [ μ 1 μ 2 ⋯ μ n ] T boldsymbol{mu}=begin{bmatrix}mu_1&mu_2&cdots&mu_nend{bmatrix}^T μ=[μ1μ2⋯μn]T、 Σ = [ Cov ( x 1 , x 1 ) Cov ( x 1 , x 2 ) ⋯ Cov ( x 1 , x n ) Cov ( x 2 , x 1 ) Cov ( x 2 , x 2 ) ⋯ Cov ( x 2 , x n ) ⋮ ⋮ ⋱ ⋮ Cov ( x n , x 1 ) Cov ( x n , x 2 ) ⋯ Cov ( x n , x n ) ] boldsymbol{Sigma}=begin{bmatrix}text{Cov}(x_1,x_1)&text{Cov}(x_1,x_2)&cdots&text{Cov}(x_1,x_n)\text{Cov}(x_2,x_1)&text{Cov}(x_2,x_2)&cdots&text{Cov}(x_2,x_n)\vdots&vdots&ddots&vdots\text{Cov}(x_n,x_1)&text{Cov}(x_n,x_2)&cdots&text{Cov}(x_n,x_n)\end{bmatrix} Σ=⎣ ⎡Cov(x1,x1)Cov(x2,x1)⋮Cov(xn,x1)Cov(x1,x2)Cov(x2,x2)⋮Cov(xn,x2)⋯⋯⋱⋯Cov(x1,xn)Cov(x2,xn)⋮Cov(xn,xn)⎦ ⎤、 Λ = Σ − 1 boldsymbol{Lambda}=boldsymbol{Sigma}^{-1} Λ=Σ−1。
若 x boldsymbol{x} x的联合概率密度为:
f ( x ) = ( 2 π ) − n 2 ∣ Σ ∣ − 1 2 e − 1 2 ( x − μ ) T Λ ( x − μ ) f(boldsymbol x)=(2pi)^{-frac{n}{2}}{midboldsymbol{Sigma}mid}^{-frac{1}{2}}e^{-frac{1}{2}(boldsymbol{x}-boldsymbol{mu})^Tboldsymbol{Lambda}(boldsymbol{x}-boldsymbol{mu})} f(x)=(2π)−2n∣Σ∣−21e−21(x−μ)TΛ(x−μ)
则 x boldsymbol{x} x服从 n n n元高斯分布。其中 ∣ Σ ∣ midboldsymbol{Sigma}mid ∣Σ∣为 Σ boldsymbol{Sigma} Σ的行列式。
当 x boldsymbol{x} x各个分量都相互独立时 Σ boldsymbol{Sigma} Σ为对角矩阵。
对于能分成两类的样本 X = { x 1 , x 2 , ⋯ , x m } , x j = [ x j , 1 x j , 2 ⋯ x j , n ] T , j = 1 , 2 , ⋯ , m X={boldsymbol x_1,boldsymbol x_2,cdots,boldsymbol x_m} ,quad boldsymbol{x}_j=begin{bmatrix}x_{j,1}&x_{j,2}&cdots&x_{j,n}end{bmatrix}^T , j=1,2,cdots,m X={x1,x2,⋯,xm} ,xj=[xj,1xj,2⋯xj,n]T , j=1,2,⋯,m,其类别 Y ∼ B ( ϕ ) , ϕ = ∑ j = 1 m I { y j = 1 } m , Y = [ y 1 y 2 ⋯ y m ] T boldsymbol{Y}thicksim B(phi) ,quadphi=frac{sum_{j=1}^mI{y_j=1}}{m} , boldsymbol{Y}=begin{bmatrix}y_1&y_2&cdots&y_mend{bmatrix}^T Y∼B(ϕ) ,ϕ=m∑j=1mI{yj=1} , Y=[y1y2⋯ym]T,对于每类样本有:
x
j
∣
y
j
=
0
∼
N
(
μ
0
,
Σ
)
,
x
j
∣
y
j
=
1
∼
N
(
μ
1
,
Σ
)
,
begin{matrix}boldsymbol x_j|y_j=0thicksim N(boldsymbol mu_0,boldsymbol{Sigma}) , boldsymbol x_j|y_j=1thicksim N(boldsymbol mu_1,boldsymbol{Sigma})end{matrix} ,
xj∣yj=0∼N(μ0,Σ) , xj∣yj=1∼N(μ1,Σ) ,
μ
k
=
∑
j
=
0
m
(
I
{
y
j
=
k
}
x
j
)
∑
j
=
1
m
I
(
y
j
=
k
)
,
k
∈
{
0
,
1
}
boldsymbol mu_k=frac{sum_{j=0}^m(I{y_j=k}boldsymbol x_j)}{sum_{j=1}^mI(y_j=k)},kin {0,1}
μk=∑j=1mI(yj=k)∑j=0m(I{yj=k}xj),k∈{0,1}
Σ
=
1
m
∑
j
=
1
m
(
x
j
−
μ
y
j
)
(
x
j
−
μ
y
j
)
T
boldsymbol{Sigma}=frac{1}{m}sum_{j=1}^m(boldsymbol x_j-boldsymbol mu_{y_j})(boldsymbol x_j-boldsymbol mu_{y_j})^T
Σ=m1j=1∑m(xj−μyj)(xj−μyj)T
指数型分布族:分布律或概率密度满足 P ( y ; η ) = b ( y ) e η T T ( y ) − a ( n ) P(y;boldsymbol{eta})=b(y)e^{boldsymbol{eta}^TT(y)-a(n)} P(y;η)=b(y)eηTT(y)−a(n),其中 η boldsymbol{eta} η为自然参数,通常充分统计量 T ( y ) = y T(y)=y T(y)=y,固定参数 a a a、 b b b、 T T T上公式可以定义一种概率分布。
{ x ∣ y = 1 ∼ E x p F a m i l y ( μ 1 ) x ∣ y = 0 ∼ E x p F a m i l y ( μ 0 ) begin{cases} xmid y=1thicksim ExpFamily(mu_1)\ xmid y=0thicksim ExpFamily(mu_0)end{cases} {x∣y=1∼ExpFamily(μ1)x∣y=0∼ExpFamily(μ0) ⇒ Rightarrow ⇒ P ( y = 1 ∣ x ) 是logistic函数 P(y=1mid x)text{是logistic函数} P(y=1∣x)是logistic函数。
NBM(朴素贝叶斯)
贝叶斯公式:
P ( B i ∣ A ) = P ( B i ) P ( A ∣ B i ) ∑ j = 1 n P ( B j ) P ( A ∣ B j ) P(B_imid A)=frac{P(B_i)P(Amid B_i)}{sum_{j=1}^n P(B_j)P(Amid B_j)} P(Bi∣A)=∑j=1nP(Bj)P(A∣Bj)P(Bi)P(A∣Bi)
有
m
m
m个样本,每个样本有
n
n
n个属性:
x
=
[
x
1
,
1
x
1
,
2
⋯
x
1
,
n
x
2
,
1
x
2
,
2
⋯
x
2
,
n
⋮
⋮
⋱
⋮
x
m
,
1
x
m
,
2
⋯
x
m
,
n
]
boldsymbol{x}=begin{bmatrix}x_{1,1}&x_{1,2}&cdots&x_{1,n}\x_{2,1}&x_{2,2}&cdots&x_{2,n}\vdots&vdots&ddots&vdots\x_{m,1}&x_{m,2}&cdots&x_{m,n}end{bmatrix}
x=⎣
⎡x1,1x2,1⋮xm,1x1,2x2,2⋮xm,2⋯⋯⋱⋯x1,nx2,n⋮xm,n⎦
⎤;
样本的类别:
y
=
[
y
1
y
2
⋮
y
m
]
,
y
j
∈
y
boldsymbol{y}=begin{bmatrix}y_{1}\y_{2}\vdots\y_{m}end{bmatrix},y_jinmathcal{y}
y=⎣
⎡y1y2⋮ym⎦
⎤,yj∈y,其中
y
=
{
c
1
,
c
2
,
⋯
,
c
,
⋯
,
c
p
}
mathcal{y}={c_1,c_2,cdots,c,cdots,c_p}
y={c1,c2,⋯,c,⋯,cp}含
p
p
p个类别;
对于一个样本 x x x,选择能使后验概率 P ( c ∣ x ) P(cmid x) P(c∣x)最大的 c c c作为 x x x的类别 y ^ hat{y} y^。朴素贝叶斯的训练过程就是基于训练集 x boldsymbol{x} x来估计后验概率 P ( c ∣ x j ) P(cmid boldsymbol{x}_j) P(c∣xj),设 ∀ j = 1 , 2 , ⋯ m forall j=1,2,cdots m ∀j=1,2,⋯m, x j x_{j} xj的每个属性都是相互独立的,则有 P ( c ∣ x j ) = P ( c ) P ( x j ∣ c ) P ( x j ) = P ( c ) P ( x j ) ∏ i = 1 n P ( x j , i ∣ c ) P(cmid boldsymbol{x}_j)=frac{P(c)P(boldsymbol{x}_jmid c)}{P(boldsymbol{x}_j)}=frac{P(c)}{P(boldsymbol{x}_j)}prod_{i=1}^nP(x_{j,i}mid c) P(c∣xj)=P(xj)P(c)P(xj∣c)=P(xj)P(c)∏i=1nP(xj,i∣c)。
求函数能使 f ( x ) f(x) f(x)取得最大值的所有 x x x值:
arg max x ∈ S f ( x ) = { x ∣ x ∈ S ∩ ∀ t ∈ S : f ( t ) < f ( x ) } {argmax}_{xin S}{f(x)}={xmid x in S cap forall tin S:f(t)<f(x)} argmaxx∈Sf(x)={x∣x∈S∩∀t∈S:f(t)<f(x)}
y
^
j
=
arg
max
c
∈
y
f
j
(
c
)
,
hat{y}_j={argmax}_{cinmathcal{y}}{f_j(c)},
y^j=argmaxc∈yfj(c),
f
j
(
c
)
=
P
(
c
)
∏
i
=
1
n
P
(
x
j
,
i
∣
c
)
f_j(c)={P(c)prod_{i=1}^{n}{P(x_{j,i}mid c)}}
fj(c)=P(c)i=1∏nP(xj,i∣c)
f
j
(
c
)
f_j(c)
fj(c)解释为
x
j
boldsymbol{x}_j
xj的类别为
c
c
c的概率 与 在
x
j
boldsymbol{x}_j
xj的类别为
c
c
c条件下
x
j
,
i
x_{j,i}
xj,i取当前值的概率 之积 之积,就是用于比较的后验概率了。分母
P
(
x
j
)
P(boldsymbol{x}_j)
P(xj)通常是定值故忽略。
朴素贝叶斯中样本属性等都是随机变量,其分布函数(律)中参数即训练参数,利用极大似然估计去确定这些参数。
极大似然估计
假定样本满足某一分布,试图求这个分布的分布函数(律)中参数。
x
c
mathcal{x}_c
xc为由
x
boldsymbol{x}
x中类别为
c
c
c的样本组成的集合,则:
L
(
θ
c
)
=
P
(
x
c
∣
θ
c
)
=
∏
x
∈
x
c
P
(
x
∣
θ
c
)
L(boldsymbol{theta}_c)=P(mathcal{x}_c|boldsymbol{theta}_c)=prod_{boldsymbol{x}in mathcal{x}_c}{P(boldsymbol{x}mid boldsymbol{theta}_c)}
L(θc)=P(xc∣θc)=x∈xc∏P(x∣θc)
通常为了便于后续计算取对数,然后的对数似然函数:
L
L
(
θ
c
)
=
log
L
(
θ
c
)
=
∑
j
=
0
m
I
{
y
j
=
c
}
log
(
P
(
x
j
∣
θ
c
)
)
LL(boldsymbol{theta}_c)=log L(boldsymbol{theta}_c)=sum_{j=0}^m{I{y_j=c}log(P(boldsymbol{x}_jmid boldsymbol{theta}_c))}
LL(θc)=logL(θc)=j=0∑mI{yj=c}log(P(xj∣θc))
θ c n e w = arg max θ c L L ( θ c ) boldsymbol{theta}_c^{new}={argmax}_{boldsymbol{theta}_c}LL(boldsymbol{theta}_c) θcnew=argmaxθcLL(θc)
NN(人工神经网络)
划分超平面中的不同样本需要若干次线性划分。训练集中的每个数据点都是超空间中的点,每个神经元的权重为超平面的参数,更新参数来调整超平面位置。而激励函数可以看做让超平面的两面拥有正反之分,用于构造多层神经网络。神经元本身可以看做生物神经元的抽象。NN在数据较多时效果较好。

上图还包括了BP算法(误差逆传播算法),它为NN更新每个神经元的权值。
对样本
X
=
[
x
0
x
1
x
2
⋯
x
I
0
]
T
boldsymbol{X}=begin{bmatrix}x_0&x_1&x_2&cdots&x_{I_0}end{bmatrix}^T
X=[x0x1x2⋯xI0]T,NN使
X
boldsymbol{X}
X作为无前驱神经元的神经元的输出(注意不是输入),并试图获得无后继神经元的一个或几个神经元的输出作为神经网络的输出。这些无前驱的神经元构成输入层,无后继的神经元构成输出层,其余按照其连接次序构成隐层(可以有许多层),隐层和输出层神经元会参与误差逆传播的过程而输入层不会,输入层也没有阈值
x
0
x_0
x0。所谓阈值就是一个固定的值加在输入的一个特定位置中一起交给神经元计算,对应于阈值的权值也会在逆传播中更新,但是“阈值的误差”传递到哪里去了呢?消失了,因为阈值类似输入层神经元,是不参与逆传播的。NN的学习过程为计算每一个神经元的权重
W
boldsymbol{W}
W(其实就是分割数据点的超平面表达式的参数)。
l
W
=
[
l
w
1
,
0
l
w
1
,
1
⋯
l
w
1
,
i
⋯
l
w
1
,
I
l
l
w
2
,
0
l
w
2
,
1
⋯
l
w
2
,
i
⋯
l
w
2
,
I
l
⋮
⋮
⋱
⋮
⋱
⋮
l
w
j
,
0
l
w
j
,
1
⋯
l
w
j
,
i
⋯
l
w
j
,
I
l
⋮
⋮
⋱
⋮
⋱
⋮
l
w
J
l
,
0
l
w
J
l
,
1
⋯
l
w
J
l
,
i
⋯
l
w
J
l
,
I
l
]
,
l
=
0
,
1
,
⋯
,
L
,
i
=
1
,
2
,
⋯
,
I
l
,
j
=
1
,
2
,
⋯
,
J
l
^lboldsymbol{W}=begin{bmatrix}^lw_{1,0}&^lw_{1,1}&cdots&^lw_{1,i}&cdots&^lw_{1,I_l}\^lw_{2,0}&^lw_{2,1}&cdots&^lw_{2,i}&cdots&^lw_{2,I_l}\vdots&vdots&ddots&vdots&ddots&vdots\^lw_{j,0}&^lw_{j,1}&cdots&^lw_{j,i}&cdots&^lw_{j,I_l}\vdots&vdots&ddots&vdots&ddots&vdots\^lw_{J_l,0}&^lw_{J_l,1}&cdots&^lw_{J_l,i}&cdots&^lw_{J_l,I_l}end{bmatrix} ,quad l=0,1,cdots,L , i=1,2,cdots,I_l , j=1,2,cdots,J_l
lW=⎣
⎡lw1,0lw2,0⋮lwj,0⋮lwJl,0lw1,1lw2,1⋮lwj,1⋮lwJl,1⋯⋯⋱⋯⋱⋯lw1,ilw2,i⋮lwj,i⋮lwJl,i⋯⋯⋱⋯⋱⋯lw1,Illw2,Il⋮lwj,Il⋮lwJl,Il⎦
⎤ ,l=0,1,⋯,L , i=1,2,⋯,Il , j=1,2,⋯,Jl
权重
W
boldsymbol{W}
W是三维的但不是“三维矩阵”,因为每层的尺寸未必相同。左上角标
l
l
l代表层序号,
l
=
0
l=0
l=0代表输入层。
L
L
L为总层数,也叫深度,包含许多隐层的复杂神经网络形成深度学习。
J
l
J_l
Jl为第
l
l
l层神经元个数,也叫宽度。
I
l
I_l
Il为第
l
l
l层的输入值的属性数,它可以是样本
X
boldsymbol{X}
X的属性数也可以是
J
l
−
1
+
1
J_{l-1}+1
Jl−1+1,即
I
l
=
J
j
−
1
I_l=J_{j-1}
Il=Jj−1。上图的
I
I
I和
J
J
J都没写角标,但注意不同层的
I
I
I或
J
J
J往往不相同。
SVM(支持向量机)
SVM有严格的数学理论支持,不依靠统计方法;利用核函数可以处理非线性分类任务;最终决策函数只由少数样本所确定(不代表SVM会丢弃样本,SVM复杂度是和样本数有关的),所以SVM避免了维数灾难并对缺失值敏感。SVM算法时间和空间复杂度都较大,适用于少量样本分类任务。
x
=
[
x
1
,
1
x
1
,
2
⋯
x
1
,
n
x
2
,
1
x
2
,
2
⋯
x
2
,
n
⋮
⋮
⋱
⋮
x
m
,
1
x
m
,
2
⋯
x
m
,
n
]
T
boldsymbol{x}=begin{bmatrix}x_{1,1}&x_{1,2}&cdots&x_{1,n}\x_{2,1}&x_{2,2}&cdots&x_{2,n}\vdots&vdots&ddots&vdots\x_{m,1}&x_{m,2}&cdots&x_{m,n}end{bmatrix}^T
x=⎣
⎡x1,1x2,1⋮xm,1x1,2x2,2⋮xm,2⋯⋯⋱⋯x1,nx2,n⋮xm,n⎦
⎤T为
m
m
m条样本(没错需要转置,这里训练集的每条样本的属性都是竖着的一列),它的类别为
y
=
[
y
1
y
2
⋯
y
m
]
T
boldsymbol{y}=begin{bmatrix}y_{1}&y_{2}&cdots&y_{m}end{bmatrix}^T
y=[y1y2⋯ym]T。对于新样本
x
+
boldsymbol{x}^+
x+,SVM试图求解:
y
^
=
f
α
(
x
)
=
g
(
∑
j
=
1
m
α
j
y
j
κ
(
x
j
,
x
+
)
+
b
)
,
g
(
z
)
=
{
+
1
,
z
≥
0
−
1
,
o
t
h
e
r
w
i
s
e
hat y=f_{boldsymbol{alpha}}(boldsymbol x)=gBig(sum_{j=1}^m{alpha_j y_jkappa(boldsymbol x_j,boldsymbol{x}^+)+b}Big) ,quad g(z)=begin{cases}+1&,zgeq0\-1&,otherwiseend{cases}
y^=fα(x)=g(j=1∑mαjyjκ(xj,x+)+b) ,g(z)={+1−1,z≥0,otherwise
SVM通过改变参数
α
boldsymbol{alpha}
α来使
f
f
f正确分类:
α
n
e
w
=
max
α
W
(
α
)
s.t.
∑
j
=
1
m
α
j
y
j
=
0
,
C
≥
α
j
≥
0
,
j
,
k
=
1
,
2
,
⋯
m
boldsymbolalpha^{new}=max_{boldsymbol{alpha}}W(boldsymbol{alpha})quad text{s.t.} sum_{j=1}^m{alpha_j y_j}=0 , Cgeqalpha_jgeq 0 , j,k=1,2,cdots m
αnew=αmaxW(α)s.t. j=1∑mαjyj=0 , C≥αj≥0 , j,k=1,2,⋯m
其中
W
W
W是一个函数:
W ( α ) = ∑ j = 1 m α j − 1 2 ∑ j = 1 m ∑ k = 1 m α j α k y j y k κ ( x j , x k ) W(boldsymbol{alpha})=sum_{j=1}^malpha_j-frac{1}{2}sum_{j=1}^msum_{k=1}^m{alpha_jalpha_ky_j y_kkappa(boldsymbol{x}_j,boldsymbol{x}_k)} W(α)=j=1∑mαj−21j=1∑mk=1∑mαjαkyjykκ(xj,xk)
然后这个 α ^ hat{boldsymbol{alpha}} α^就用来预测新的数据了(之前参数用的都是 θ ^ hat{boldsymbol{theta}} θ^)。 α boldsymbol{alpha} α初值为 0 boldsymbol{0} 0。 C C C为常数,描述SVM对个别数据分类出错的容忍程度。函数 g g g可以认为是sigmoid函数。 W W W里面还有个 κ kappa κ, κ kappa κ是核函数,也是一个函数。
常见核函数:
| 核函数 | κ ( x j , x k ) kappa(boldsymbol{x}_j,boldsymbol{x}_k) κ(xj,xk) | 参数说明 |
|---|---|---|
| 线性核 | x j T x k boldsymbol{x}_j^Tboldsymbol{x}_k xjTxk | |
| 多项式核 | ( x j T x k ) d , d ≥ 1 (boldsymbol{x}_j^Tboldsymbol{x}_k)^d ,quad dgeq 1 (xjTxk)d ,d≥1 | d d d为多项式次数 |
| 高斯核 | e ∥ x j − x k ∥ 2 − 2 σ 2 , σ > 0 e^{frac{{Vertboldsymbol{x}_j-boldsymbol{x}_kVert}^2}{-2sigma^2} ,quad sigma>0} e−2σ2∥xj−xk∥2 ,σ>0 | σ sigma σ为width |
| 拉普拉斯核 | e ∥ x j − x k ∥ − σ , σ > 0 e^{frac{{Vertboldsymbol{x}_j-boldsymbol{x}_kVert}}{-sigma} ,quad sigma>0} e−σ∥xj−xk∥ ,σ>0 | |
| sigmoid核 | tanh ( β x j T x k + θ ) , β > 0 , θ < 0 tanh(betaboldsymbol{x}_j^Tboldsymbol{x}_k+theta) ,quadbeta>0,theta<0 tanh(βxjTxk+θ) ,β>0,θ<0 |
取
α
boldsymbol{alpha}
α中的值
α
j
alpha_j
αj、
α
k
alpha_k
αk,注意一次取两个值,则有:
E
j
=
y
^
j
−
y
j
,
E
k
=
y
^
k
−
y
k
E_j=hat{y}_j-y_j , E_k=hat{y}_k-y_k
Ej=y^j−yj , Ek=y^k−yk
L
=
{
max
(
0
,
α
k
−
α
j
)
,
y
j
≠
y
k
max
(
0
,
α
k
+
α
j
−
C
)
,
y
j
=
y
k
L=begin{cases}max(0,alpha_k-alpha_j) ,& y_jnot =y_k\max(0,alpha_k+alpha_j-C) ,& y_j=y_kend{cases}
L={max(0,αk−αj) ,max(0,αk+αj−C) ,yj=ykyj=yk
H
=
{
max
(
C
,
α
k
−
α
j
+
C
)
,
y
j
≠
y
k
max
(
0
,
α
k
+
α
j
)
,
y
j
=
y
k
H=begin{cases}max(C,alpha_k-alpha_j+C) ,& y_jnot =y_k\max(0,alpha_k+alpha_j) ,& y_j=y_kend{cases}
H={max(C,αk−αj+C) ,max(0,αk+αj) ,yj=ykyj=yk
α
k
n
e
w
=
min
(
H
,
max
(
L
,
α
k
+
y
k
(
E
j
−
E
k
)
κ
(
x
j
,
x
j
)
+
κ
(
x
k
,
x
k
)
−
2
κ
(
x
j
,
x
k
)
)
)
alpha_k^{new}=minbigg(H,maxbigg(L, alpha_k+frac{y_k(E_j-E_k)}{kappa(boldsymbol{x}_j,boldsymbol{x}_j)+kappa(boldsymbol{x}_k,boldsymbol{x}_k)-2kappa(boldsymbol{x}_j,boldsymbol{x}_k)}bigg)bigg)
αknew=min(H,max(L,αk+κ(xj,xj)+κ(xk,xk)−2κ(xj,xk)yk(Ej−Ek)))
α
j
n
e
w
=
α
j
+
(
y
j
y
k
)
(
α
k
−
α
k
n
e
w
)
alpha_j^{new}=alpha_j+(y_jy_k)(alpha_k-alpha_k^{new})
αjnew=αj+(yjyk)(αk−αknew)
b
n
e
w
=
{
b
j
,
α
j
∈
(
0
,
C
)
b
k
,
α
k
∈
(
0
,
C
)
b
j
+
b
k
2
,
otherwise
,
b
j
=
b
−
E
j
−
y
j
κ
(
x
j
,
x
j
)
(
α
j
n
e
w
−
α
j
)
−
y
k
κ
(
x
k
,
x
j
)
(
α
k
n
e
w
−
α
k
)
b
k
=
b
−
E
k
−
y
j
κ
(
x
j
,
x
k
)
(
α
j
n
e
w
−
α
j
)
−
y
k
κ
(
x
k
,
x
k
)
(
α
k
n
e
w
−
α
k
)
b^{new}=begin{cases}b_j ,&alpha_jin(0,C)\b_k ,&alpha_kin(0,C)\frac{b_j+b_k}{2} ,&text{otherwise}end{cases} ,quadbegin{matrix}b_j=b-E_j-y_jkappa(boldsymbol{x}_j,boldsymbol{x}_j)(alpha_j^{new}-alpha_j)-y_kkappa(boldsymbol{x}_k,boldsymbol{x}_j)(alpha_k^{new}-alpha_k)\b_k=b-E_k-y_jkappa(boldsymbol{x}_j,boldsymbol{x}_k)(alpha_j^{new}-alpha_j)-y_kkappa(boldsymbol{x}_k,boldsymbol{x}_k)(alpha_k^{new}-alpha_k)end{matrix}
bnew=⎩
⎨
⎧bj ,bk ,2bj+bk ,αj∈(0,C)αk∈(0,C)otherwise ,bj=b−Ej−yjκ(xj,xj)(αjnew−αj)−ykκ(xk,xj)(αknew−αk)bk=b−Ek−yjκ(xj,xk)(αjnew−αj)−ykκ(xk,xk)(αknew−αk)
迭代更新参数
α
boldsymbol{alpha}
α和
b
b
b直至收敛。
以上的似乎使得“支持向量机”这个名字变得无法理解。那么请看以下:
x = [ x 1 x 2 ⋯ x n ] boldsymbol{x}=begin{bmatrix}x_1&x_2&cdots&x_nend{bmatrix} x=[x1x2⋯xn]则L2范数 ∥ x ∥ = ∑ i = 1 n ∣ x i ∣ 2 |boldsymbol{x}|=sqrt{sum_{i=1}^n{{mid x_imid}^2}} ∥x∥=∑i=1n∣xi∣2
在样本空间中类别为 y ∈ { − 1 , + 1 } yin{-1,+1} y∈{−1,+1}的任意一个点 x j = [ x j , 1 x j , 2 ⋯ x j , n ] T boldsymbol{x}_j=begin{bmatrix}x_{j,1}&x_{j,2}&cdots&x_{j,n}end{bmatrix}^T xj=[xj,1xj,2⋯xj,n]T到超平面 w T x + b = 0 boldsymbol{w}^Tboldsymbol{x}+b=0 wTx+b=0的距离为函数间隔 γ ^ = y ( w T x + b ) hat{gamma}=y(boldsymbol{w}^Tboldsymbol{x}+b) γ^=y(wTx+b)。但是函数间隔会受到参数影响,超平面不变情况下参数同乘一个数的话函数间隔会变,所以采用几何间隔 γ j = y j ( ( w ∥ w ∥ ) T x j + b ∥ w ∥ ) = γ ^ j ∥ w ∥ gamma_j=y_jbig((frac{boldsymbol{w}}{|boldsymbol{w}|})^Tboldsymbol{x}_j+frac{b}{|boldsymbol{w}|}big)=frac{hat{gamma}_j}{|boldsymbol{w}|} γj=yj((∥w∥w)Txj+∥w∥b)=∥w∥γ^j描述样本点 x j boldsymbol{x}_j xj到超平面的距离。 w = [ w 1 w 2 ⋯ w n ] boldsymbol{w}=begin{bmatrix}w_1&w_2&cdots&w_nend{bmatrix} w=[w1w2⋯wn]为法向量。
x j boldsymbol{x}_j xj可能是线性不可分的,则需要 φ ( x ) varphi(boldsymbol{x}) φ(x)函数将自变量映射至更高维度的特征空间,因为如果原始空间是有限维则必然存在一个高维特征空间使样本可分。SVM并不是采用多么复杂的界线去分隔数据,而是为数据添加一些“计算属性”从而将数据映射到高维空间中再线性分割。
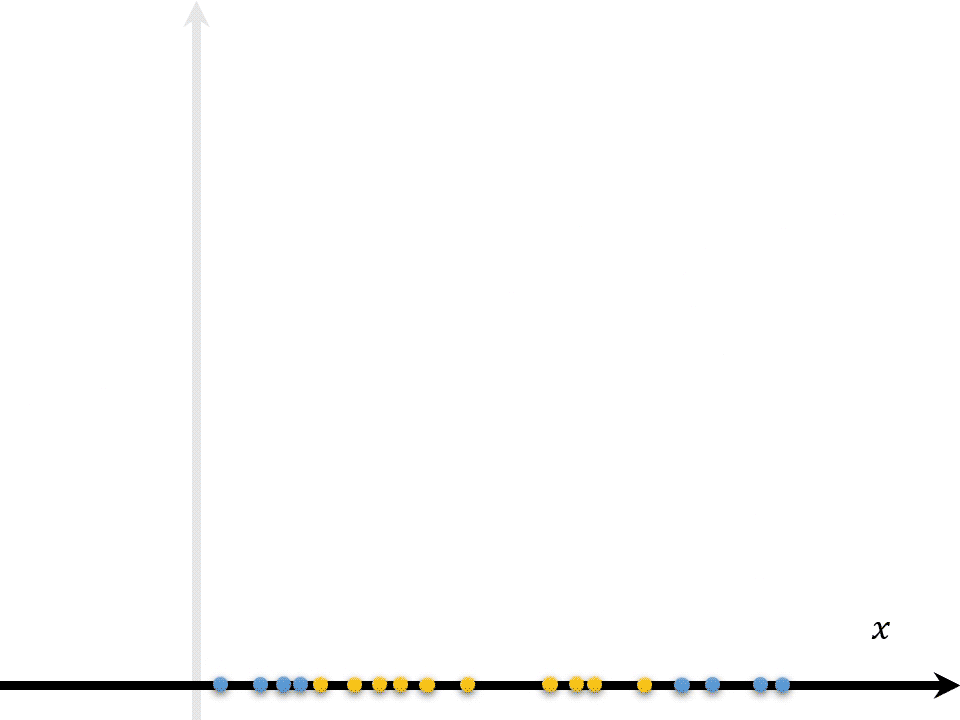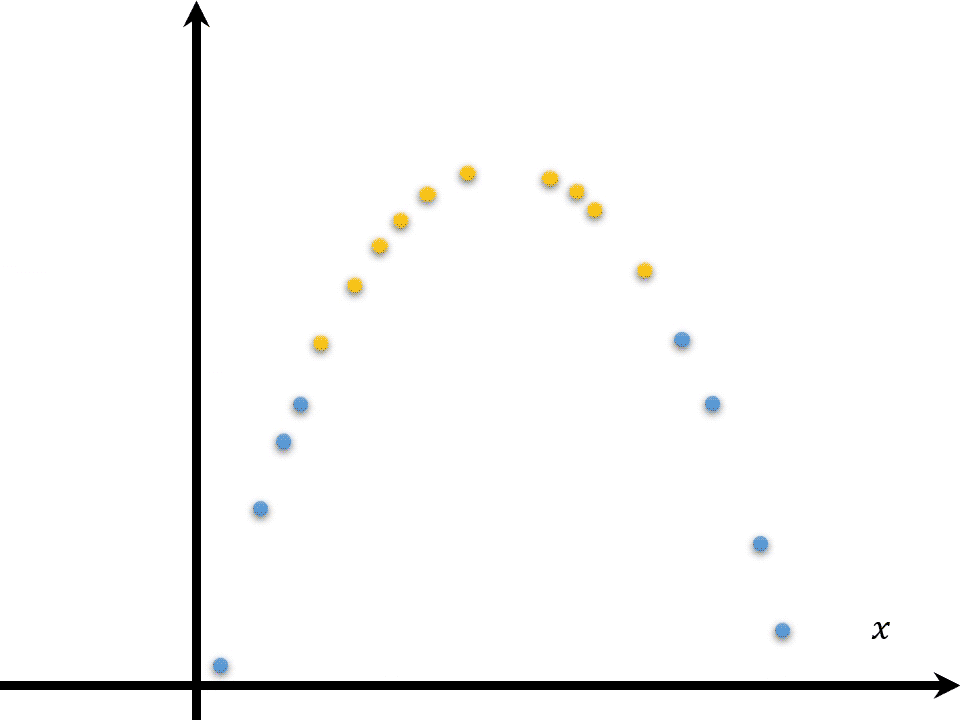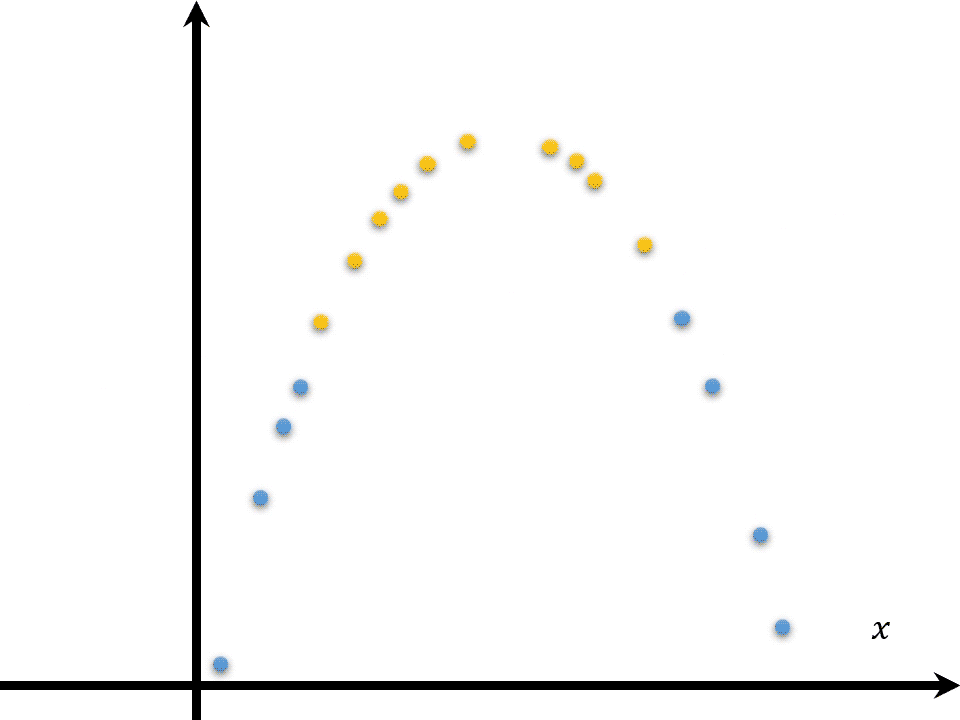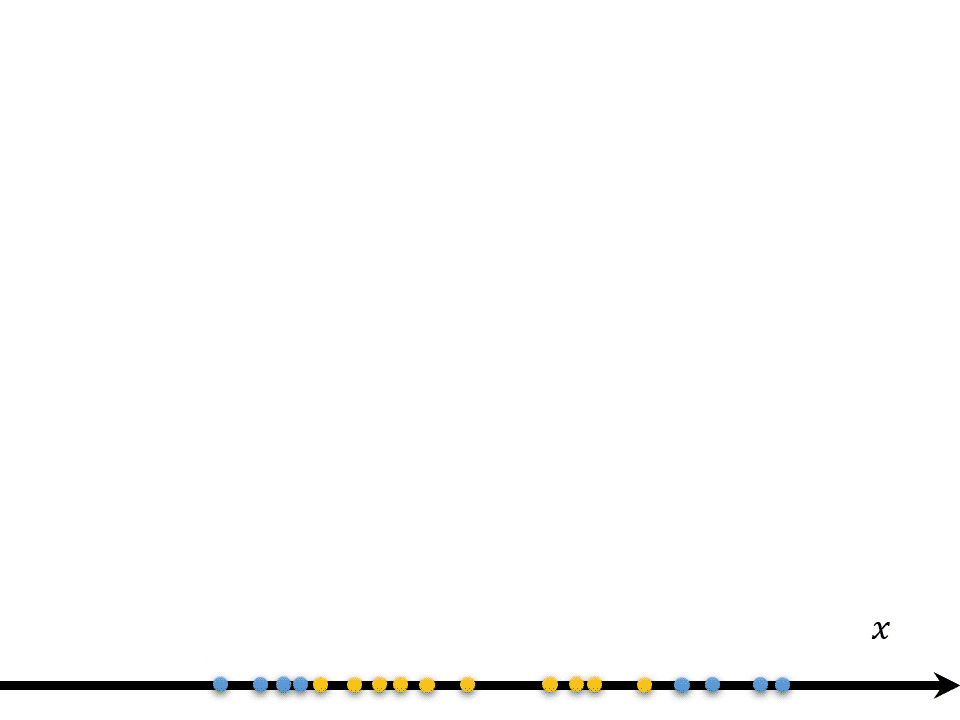
∃ φ s.t. κ ( x j , x k ) = φ ( x j ) T φ ( x k ) ⇔ z T κ z ≥ 0 , κ j , k = κ ( x j , x k ) , z ∈ R m , j , k = 1 , 2 , ⋯ , m existsvarphiquadtext{s.t.} kappa(boldsymbol x_j,boldsymbol x_k)=varphi(boldsymbol x_j)^Tvarphi(boldsymbol x_k)Leftrightarrow boldsymbol{z}^Tboldsymbol{kappa}boldsymbol{z}geq 0 ,quad kappa_{j,k}=kappa(boldsymbol x_j,boldsymbol x_k) , boldsymbol{z}inmathbb{R}^m , j,k=1,2,cdots,m ∃φs.t. κ(xj,xk)=φ(xj)Tφ(xk)⇔zTκz≥0 ,κj,k=κ(xj,xk) , z∈Rm , j,k=1,2,⋯,m
其中 κ ( x j , x k ) kappa(boldsymbol{x}_j,boldsymbol{x}_k) κ(xj,xk)为核函数。这样就不用去计算函数 φ varphi φ了, φ ( x j ) T φ ( x k ) varphi(boldsymbol x_j)^Tvarphi(boldsymbol x_k) φ(xj)Tφ(xk)具体形态参见上文核函数表。
任何一个求极大值的线性规划问题都有一个求极小值的对偶问题与之对应,反之亦然。对偶问题可能比原问题更易求解。SVM试图找到
w
boldsymbol{w}
w、
b
b
b使
γ
gamma
γ最大,将不同类别的样本分开,并且这个超平面尽可能远离样本。所以优化目标为:
max
w
,
b
γ
^
∥
w
∥
s.t.
y
j
(
w
T
φ
(
x
j
)
+
b
)
≥
γ
^
,
j
=
1
,
2
,
⋯
,
m
max_{w,b}{frac{hatgamma}{|boldsymbol{w}|}}quadtext{s.t.} y_j(boldsymbol{w}^Tvarphi(boldsymbol{x}_j)+b)geqhatgamma,quad j=1,2,cdots,m
w,bmax∥w∥γ^s.t. yj(wTφ(xj)+b)≥γ^,j=1,2,⋯,m
令
γ
^
=
1
hat{gamma}=1
γ^=1则等价于(便于计算):
min
w
,
b
∥
w
∥
2
2
s.t.
y
j
(
w
T
φ
(
x
j
)
+
b
)
≥
1
,
j
=
1
,
2
,
⋯
,
m
min_{boldsymbol{w},b}frac{|boldsymbol{w}|^2}{2}quadtext{s.t.} y_j(boldsymbol{w}^Tvarphi(boldsymbol{x}_j)+b)geq 1,quad j=1,2,cdots,m
w,bmin2∥w∥2s.t. yj(wTφ(xj)+b)≥1,j=1,2,⋯,m
其拉格朗日函数:
L
(
w
,
b
,
α
)
=
1
2
∥
w
∥
2
+
∑
j
=
1
m
α
j
(
1
−
y
j
(
w
T
φ
(
x
j
)
+
b
)
)
L(boldsymbol{w},b,boldsymbol{alpha})=frac{1}{2}|boldsymbol{w}|^2+sum_{j=1}^m{alpha_jBig(1-y_jbig(boldsymbol{w}^Tvarphi(boldsymbol{x}_j)+bbig)Big)}
L(w,b,α)=21∥w∥2+j=1∑mαj(1−yj(wTφ(xj)+b))
其对偶问题:
max
α
∑
j
=
1
m
α
j
−
1
2
∑
j
=
1
m
∑
k
=
1
m
α
j
α
k
y
j
y
k
κ
(
x
j
,
x
k
)
s.t.
∑
j
=
1
m
α
j
y
j
=
0
,
α
≥
0
,
j
,
k
=
1
,
2
,
⋯
m
max_{boldsymbol{alpha}}sum_{j=1}^malpha_j-frac{1}{2}sum_{j=1}^msum_{k=1}^m{alpha_jalpha_k y_j y_kkappa(boldsymbol{x}_j,boldsymbol{x}_k)}quad text{s.t.} sum_{j=1}^m{alpha_j y_j}=0 , alphageq 0 , j,k=1,2,cdots m
αmaxj=1∑mαj−21j=1∑mk=1∑mαjαkyjykκ(xj,xk)s.t. j=1∑mαjyj=0 , α≥0 , j,k=1,2,⋯m
当超平面将样本不同类别样本分开时,能使上面的
γ
^
=
1
hatgamma=1
γ^=1成立的
x
boldsymbol{x}
x即为支持向量。两个不同类别的支持向量到超平面的距离之和为
γ
=
2
∥
w
∥
gamma=frac{2}{|boldsymbol{w}|}
γ=∥w∥2。
同时易得
w
i
=
∑
j
=
0
m
α
j
y
j
x
j
,
i
w_i=sum_{j=0}^m{alpha_j y_j x_{j,i}}
wi=∑j=0mαjyjxj,i,
w
=
∑
j
=
0
m
α
j
y
j
x
j
boldsymbol{w}=sum_{j=0}^m{alpha_j y_j boldsymbol{x}_j}
w=∑j=0mαjyjxj。
拉格朗日乘数法:
在一组条件 ϕ ( x ) = [ ϕ 1 ( x ) ϕ 2 ( x ) ⋮ ϕ n ( x ) ] = 0 , i = 1 , 2 , ⋯ , n phi(boldsymbol{x})=begin{bmatrix}phi_1(boldsymbol{x})\phi_2(boldsymbol{x})\vdots\phi_n(boldsymbol{x})end{bmatrix}=boldsymbol{0} ,quad i=1,2,cdots,n ϕ(x)=⎣ ⎡ϕ1(x)ϕ2(x)⋮ϕn(x)⎦ ⎤=0 ,i=1,2,⋯,n下求函数 f ( x ) f(boldsymbol{x}) f(x)极值点(如有),即:
min w f ( x ) s.t. ϕ ( x ) = 0 min_w f(boldsymbol{x})quad text{s.t.} phi(boldsymbol{x})=boldsymbol{0} wminf(x)s.t. ϕ(x)=0
有拉格朗日函数:
L ( x , α ) = f ( x ) + ∑ i = 1 n α i ϕ i ( x ) L(boldsymbol{x},boldsymbolalpha)=f(boldsymbol{x})+sum_{i=1}^n{alpha_i phi_i(boldsymbol{x})} L(x,α)=f(x)+i=1∑nαiϕi(x)
其中 α boldsymbolalpha α为拉格朗日乘数。
令 ∂ L ∂ x = 0 frac{partial{L}}{partial{boldsymbol{x}}}=0 ∂x∂L=0、 ∂ L ∂ α = 0 frac{partial L}{partial boldsymbolalpha}=0 ∂α∂L=0得:
P ( x ∗ ) P(boldsymbol{x}^*) P(x∗)是驻点 ⇐ ∃ α ∗ s.t. ∂ L ( x ∗ , α ∗ ) ∂ x = 0 , ∂ L ( x ∗ , α ∗ ) ∂ α = 0 Leftarrow exists boldsymbol{alpha}^*quadtext{s.t.} frac{partial{L(boldsymbol{x}^*,boldsymbol{alpha}^*)}}{partialboldsymbol{x}}=0,frac{partial{L(boldsymbol{x}^*,boldsymbol{alpha}^*)}}{partialboldsymbol{alpha}}=0 ⇐∃α∗s.t. ∂x∂L(x∗,α∗)=0,∂α∂L(x∗,α∗)=0。
选择能让样本线性可分的核函数实际上是一件非常困难的事情,两类样本的边界可能十分模糊,当SVM将样本完全分开时基本上已经过拟合了。这时要采用软间隔,允许少量样本没有被正确分类。所以优化目标为:
min
w
,
b
1
2
∥
w
∥
2
+
C
∑
i
=
j
m
ξ
j
s.t.
y
j
(
w
T
x
j
+
b
)
≥
1
−
ξ
j
,
ξ
j
≥
0
min_{boldsymbol{w},b}frac{1}{2}|boldsymbol{w}|^2+Csum_{i=j}^m{xi_j}quad text{s.t.} y_j(boldsymbol{w}^Tboldsymbol{x}_j+b)geq 1-xi_j , xi_jgeq 0
w,bmin21∥w∥2+Ci=j∑mξjs.t. yj(wTxj+b)≥1−ξj , ξj≥0
其对偶问题:
max
α
W
(
α
)
s.t.
∑
j
=
1
m
α
j
y
j
=
0
,
C
≥
α
j
≥
0
,
j
=
1
,
2
,
⋯
m
max_{boldsymbol{alpha}}W(boldsymbol{alpha})quad text{s.t.} sum_{j=1}^m{alpha_j y_j}=0 , Cgeqalpha_jgeq 0 , j=1,2,cdots m
αmaxW(α)s.t. j=1∑mαjyj=0 , C≥αj≥0 , j=1,2,⋯m
其中 ξ xi ξ为松弛变量, C C C为常量, C > α j > 0 ⇒ y j ( w T x j + b ) = 1 C>alpha_j>0Rightarrow y_j(boldsymbol{w}^Tboldsymbol{x}_j+b)=1 C>αj>0⇒yj(wTxj+b)=1。就得到上文中的函数 W W W。
最后
以上就是孤独蜡烛最近收集整理的关于监督学习常见算法GDA(高斯判别分析)NBM(朴素贝叶斯)NN(人工神经网络)SVM(支持向量机)的全部内容,更多相关监督学习常见算法GDA(高斯判别分析)NBM(朴素贝叶斯)NN(人工神经网络)SVM(支持向量机)内容请搜索靠谱客的其他文章。
发表评论 取消回复