同步于Buracag的博客
优化问题一般都是通过迭代的方式来求解:通过猜测一个初始的估计 x 0 x_0 x0,然后不断迭代产生新的估计 x 1 , x 2 , . . . x t x_1, x_2, ... x_t x1,x2,...xt,希望 x t x_t xt最终收敛到期望的最优解 x ∗ x^∗ x∗。
一个好的优化算法应该是在一定的时间或空间复杂度下能够快速准确地找到最优解。同时,好的优化算法受初始猜测点的影响较小,通过迭代能稳定地找到最优解 x ∗ x^∗ x∗的邻域,然后迅速收敛于 x ∗ x^∗ x∗。
优化算法中常用的迭代方法有线性搜索和置信域方法等。线性搜索的策略是寻找方向和步长,具体算法有梯度下降法、牛顿法、共轭梯度法等。在文章中也简要介绍过梯度下降的概念,这里为使得整个体系完整故重新记录一下。
文章目录
- 1. 全局最优和局部最优
- 2. 梯度下降法
1. 全局最优和局部最优
对于很多非线性优化问题,会存在若干个局部的极小值。局部最小值,或局部最优解 x ∗ x^∗ x∗定义为:存在一个 δ > 0 delta > 0 δ>0,对于所有的满足 ∥ x − x ∗ ∥ ≤ δ ∥x−x^*∥ leq delta ∥x−x∗∥≤δ的x,公式 f ( x ∗ ) ≤ f ( x ) f(x^∗) leq f(x) f(x∗)≤f(x)成立。也就是说,在 x ∗ x^∗ x∗的附近区域内,所有的函数值都大于或者等于 f ( x ∗ ) f(x^∗) f(x∗)。
对于所有的 x ∈ A x in A x∈A,都有 f ( x ∗ ) ≤ f ( x ) f(x^∗) leq f(x) f(x∗)≤f(x)成立,则 x ∗ x^∗ x∗为全局最小值,或全局最优解。一般的,求局部最优解是容易的,但很难保证其为全局最优解。对于线性规划或凸优化问题,局部最优解就是全局最优解。
要确认一个点 x ∗ x^∗ x∗是否为局部最优解,通过比较它的邻域内有没有更小的函数值是不现实的。如果函数 f ( x ) f(x) f(x)是二次连续可微的,我们可以通过检查目标函数在点 x ∗ x^∗ x∗的梯度 ∇ f ( x ∗ ) ∇f(x^∗) ∇f(x∗)和Hessian矩阵 ∇ 2 f ( x ∗ ) nabla^2f(x^∗) ∇2f(x∗)来判断。
定理1 局部最小值的一阶必要条件: 如果 x ∗ x^∗ x∗为局部最优解并且函数 f f f在 x ∗ x^∗ x∗的邻域内一阶可微,则在 ∇ f ( x ∗ ) = 0 ∇f(x^∗) = 0 ∇f(x∗)=0。
证明. 如果函数
f
(
x
)
f(x)
f(x)是连续可微的,根据泰勒展开公式(Taylor’s Formula),函数
f
(
x
)
f(x)
f(x)的一阶展开可以近似为
(1)
f
(
x
∗
+
Δ
x
)
=
f
(
x
∗
)
+
Δ
x
T
∇
f
(
x
∗
)
f(x^∗ + Delta x) = f(x^∗) + Delta x^T nabla f(x^∗) tag{1}
f(x∗+Δx)=f(x∗)+ΔxT∇f(x∗)(1)
假设
∇
f
(
x
∗
)
≠
0
∇f(x^∗) neq 0
∇f(x∗)̸=0,则可以找到一个
Δ
x
Delta x
Δx(比如
Δ
x
=
−
α
∇
f
(
x
∗
)
Delta x = −alpha ∇f(x^∗)
Δx=−α∇f(x∗),
α
alpha
α为很小的正数),使得
(2)
f
(
x
∗
+
Δ
x
)
−
f
(
x
∗
)
=
Δ
x
T
∇
f
(
x
∗
)
≤
0
f(x^∗ + Delta x) − f(x^∗) = Delta x^T nabla f(x^∗) leq 0 tag{2}
f(x∗+Δx)−f(x∗)=ΔxT∇f(x∗)≤0(2)
这和局部最优的定义矛盾。
定理2 局部最优解的二阶必要条件: 如果 x ∗ x^∗ x∗为局部最优解并且函数 f f f在 x ∗ x^∗ x∗的领域内二阶可微,则 ∇ f ( x ∗ ) = 0 , ∇ 2 f ( x ∗ ) nabla f(x^∗)=0, nabla^2 f(x^*) ∇f(x∗)=0,∇2f(x∗)为半正定矩阵。
证明. 如果函数
f
(
x
)
f(x)
f(x)是二次连续可微的,函数
f
(
x
)
f(x)
f(x)的二阶展开可以近似为
(3)
f
(
x
∗
+
Δ
x
)
=
f
(
x
∗
)
+
Δ
x
T
∇
f
(
x
∗
)
+
1
2
Δ
x
T
(
∇
2
f
(
x
∗
)
)
Δ
x
f(x^∗ + Delta x) = f(x^∗) + Delta x^T nabla f(x^∗) + frac{1}{2}Delta x^T (nabla^2f(x^∗))Delta x tag{3}
f(x∗+Δx)=f(x∗)+ΔxT∇f(x∗)+21ΔxT(∇2f(x∗))Δx(3)
由一阶必要性定理可知
∇
f
(
x
∗
)
=
0
nabla f(x^∗) = 0
∇f(x∗)=0,则
(4)
f
(
x
∗
+
Δ
x
)
−
f
(
x
∗
)
=
1
2
Δ
x
T
(
∇
2
f
(
x
∗
)
)
Δ
x
≥
0
f(x^∗ + Delta x) − f(x^∗) = frac{1}{2}Delta x^T (nabla^2 f(x^∗))Delta x geq 0 tag{4}
f(x∗+Δx)−f(x∗)=21ΔxT(∇2f(x∗))Δx≥0(4)
即Hessian矩阵
∇
2
f
(
x
∗
)
nabla^2f(x^∗)
∇2f(x∗)为半正定矩阵。
2. 梯度下降法
梯度下降法(Gradient Descent Method),也叫最速下降法(Steepest Descend Method),经常用来求解无约束优化的极小值问题。
对于函数
f
(
x
)
f(x)
f(x),如果
f
(
x
)
f(x)
f(x)在点
x
t
x_t
xt附近是连续可微的,那么
f
(
x
)
f(x)
f(x)下降最快的方向是
f
(
x
)
f(x)
f(x)在
x
t
x_t
xt点的梯度方法的反方向。根据泰勒一阶展开公式,
(5)
f
(
x
t
+
1
)
=
f
(
x
t
+
Δ
x
)
≈
f
(
x
t
)
+
Δ
x
T
∇
f
(
x
t
)
f(x_{t+1}) = f(x_t + Delta x) approx f(x_t) + Delta x^T nabla f(x_t) tag{5}
f(xt+1)=f(xt+Δx)≈f(xt)+ΔxT∇f(xt)(5)
要使得
f
(
x
t
+
1
)
<
f
(
x
t
)
f(x_{t+1}) < f(x_t)
f(xt+1)<f(xt),就得使
Δ
x
T
∇
f
(
x
t
)
<
0
Delta x^Tnabla f(x_t) < 0
ΔxT∇f(xt)<0。我们取
Δ
x
=
−
α
∇
f
(
x
t
)
Delta x = −alpha nabla f(x_t)
Δx=−α∇f(xt)。如果
α
>
0
alpha > 0
α>0为一个够小数值时,那么
f
(
x
t
+
1
)
<
f
(
x
t
)
f(x_{t+1}) < f(x_t)
f(xt+1)<f(xt) 成立。
这样我们就可以从一个初始值
x
0
x_0
x0出发,通过迭代公式
(6)
x
t
+
1
=
x
t
−
α
t
∇
f
(
x
t
)
,
t
≥
0
x_{t+1} = x_t − alpha_tnabla f(x_t), t geq 0 tag{6}
xt+1=xt−αt∇f(xt),t≥0(6)
生成序列
x
0
,
x
1
,
x
2
,
.
.
.
x_0, x_1, x_2, ...
x0,x1,x2,... 使得
(7)
f
(
x
0
)
≥
f
(
x
1
)
≥
f
(
x
2
)
≥
.
.
.
f(x_0) geq f(x_1) geq f(x_2) geq ... tag{7}
f(x0)≥f(x1)≥f(x2)≥...(7)
如果顺利的话,序列(
x
n
x_n
xn) 收敛到局部最优解
x
∗
x^∗
x∗。注意每次迭代步长
α
alpha
α可以改变,但其取值必须合适,如果过大就不会收敛,如果过小则收敛速度太慢。
梯度下降法的示例过程可以参见下图:
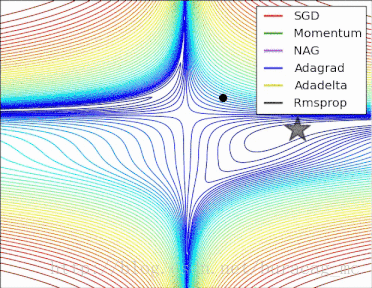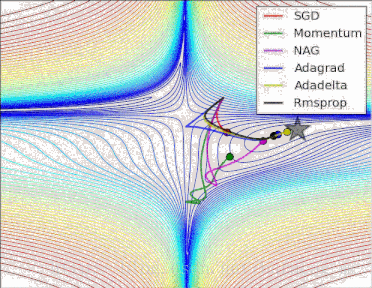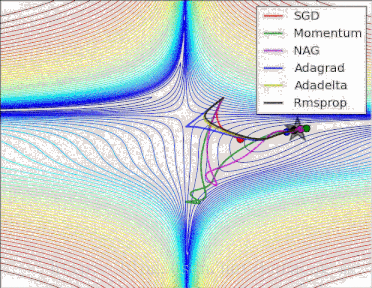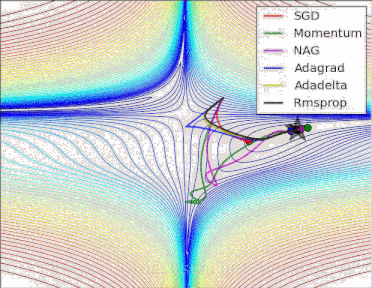
梯度下降法为一阶收敛算法,当靠近极小值时梯度变小,收敛速度会变慢,并且可能以“之字形”的方式下降。如果目标函数为二阶连续可微,我们可以采用牛顿法。牛顿法为二阶收敛算法,收敛速度更快,但是每次迭代需要计算Hessian矩阵的逆矩阵,复杂度较高。相反,如果我们要求解一个最大值问题,就需要向梯度正方向迭代进行搜索,逐渐接近函数的局部极大值点,这个过程则被称为梯度上升法(GradientAscent)。
后面准备专门整理一份梯度下降中关于批量梯度下降(BGD)、随机梯度下降(SGD)、小批量梯度下降(MBGD)、Momentum、Adagrad等资料。
主要参考https://github.com/nndl/nndl.github.io
最后
以上就是迅速可乐最近收集整理的关于数学优化2-优化算法1. 全局最优和局部最优2. 梯度下降法的全部内容,更多相关数学优化2-优化算法1.内容请搜索靠谱客的其他文章。
发表评论 取消回复