声明:本文是对西瓜书中第五章神经网络中公式推导过程补充,文章作为自己的学习笔记,欢迎大家于本人学习交流。未经本人许可,文章不得用于商业用途。转载请注明出处
本文章参考
作者: 周志华 书名:《机器学习》 出版社:清华大学出版社
南瓜书项目 链接地址:https://datawhalechina.github.io/pumpkin-book/#/
感谢此书籍和项目的原创者
如有侵犯您的知识产权和版权问题,请通知本人,本人会即时做出处理并删除文章
Email:louhergetup@163.com
目录
- 感知机
- 感知机的定义
- 感知机的几何解释
- 学习策略
- 神经网络
- 模型结构
- 标准BP算法
感知机
感知机的定义
假设输入空间是
X
⊆
R
n
mathcal{X} subseteq R^{n}
X⊆Rn,输出空间是
Y
=
{
1
,
0
}
mathcal{Y}={1,0}
Y={1,0} 。输入
x
∈
X
boldsymbol{x} in mathcal{X}
x∈X 表示实例的特征向量,对应于输入空间的点;输出
y
∈
Y
y in mathcal{Y}
y∈Y 表示实例的类别。由于输入空间到输出空间的如下函数
f
(
x
)
=
sgn
(
w
T
x
+
b
)
f(x)=operatorname{sgn}left(w^{T} x+bright)
f(x)=sgn(wTx+b)
称为感知机。其中
w
w
w 和
b
b
b 为感知机模型参数,
s
g
n
sgn
sgn 是阶跃函数,即
sgn
(
z
)
=
{
1
,
z
⩾
0
0
,
z
<
0
operatorname{sgn}(z)=left{begin{array}{ll} 1, & z geqslant 0 \ 0, & z<0 end{array}right.
sgn(z)={1,0,z⩾0z<0
感知机的几何解释
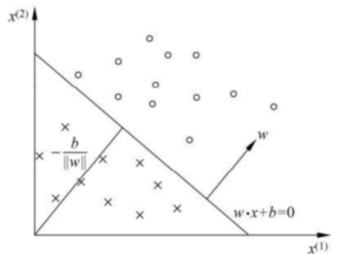
线性方程 w T x + b = 0 w^{T} x+b=0 wTx+b=0 对应于特征空间(输入空间) R n R^{n} Rn 中的一个超平面 S S S, 其中 w w w 是超平面的法向量, b b b 是超平面的截距。这个超平面将特征空间划分为两个部分。位于两边的点(特征向量)分别被分为正、负两类。因此,超平面 S S S 称为分离超平面,如图所示
学习策略
假设训练数据集是线性可分的,感知机学习的目标是求得一个能够将训练集正实例点和负实例点完全正确分开的超平面。为了找出这样的超平面 S S S ,即确定感知机模型参数 w w w 和 b b b ,需要确定一个学习策略,即定义损失函数并将损失函数极小化。损失函数的一个自然选择是误分类点的总数。但是,这样的损失函数不是参数 w w w 和 b b b 的连续可导函数,不易优化,所以感知机采用的损失函数为误分类点到超平面的总距离。
输入空间
R
n
R^{n}
Rn 中点
x
0
boldsymbol{x}_{0}
x0 到超平面
S
S
S 的距离公式为
∣
w
T
x
0
+
b
∣
∥
w
∥
frac{left|w^{T} x_{0}+bright|}{|w|}
∥w∥∣∣wTx0+b∣∣
其中,
∥
w
∥
|boldsymbol{w}|
∥w∥ 表示向量
w
w
w 的模长。若将
b
b
b 看成哑结点,也即合并进
w
w
w 可得
∣
w
^
T
x
^
0
∣
∥
w
^
∥
frac{left|hat{w}^{T} hat{x}_{0}right|}{|hat{w}|}
∥w^∥∣∣w^Tx^0∣∣
设误分类点集合为
M
M
M,那么所有误分类点到超平面
S
S
S 的总距离为
∑
x
^
i
∈
M
∣
w
^
T
x
^
i
∣
∥
w
^
∥
sum_{hat{x}_{i} in M} frac{left|widehat{w}^{T} hat{x}_{i}right|}{|widehat{w}|}
x^i∈M∑∥w
∥∣∣w
Tx^i∣∣
又因为,对于任意误分类点
x
^
i
∈
M
hat{boldsymbol{x}}_{i} in M
x^i∈M 来说都有
(
y
^
i
−
y
i
)
w
^
T
x
^
i
>
0
left(hat{y}_{i}-y_{i}right) hat{w}^{T} hat{x}_{i}>0
(y^i−yi)w^Tx^i>0
其中,
y
^
i
hat{y}_{i}
y^i 为当前感知机的输入。于是所有误分类点到超平面
S
S
S 的总距离可改写为
∑
x
^
i
∈
M
(
y
^
i
−
y
i
)
w
^
T
x
^
i
∥
w
^
∥
sum_{hat{x}_{i} in M} frac{left(hat{y}_{i}-y_{i}right) hat{w}^{T} hat{x}_{i}}{|hat{w}|}
x^i∈M∑∥w^∥(y^i−yi)w^Tx^i
不考虑
1
∥
w
^
∥
frac{1}{|hat{w}|}
∥w^∥1 就得到感知机学习的损失函数
L
(
w
^
)
=
∑
x
^
i
∈
M
(
y
^
i
−
y
i
)
w
^
T
x
^
i
L(hat{w})=sum_{hat{x}_{i} in M}left(hat{y}_{i}-y_{i}right) hat{w}^{T} hat{x}_{i}
L(w^)=x^i∈M∑(y^i−yi)w^Tx^i
显然,损失函数
L
(
w
^
)
L(hat{w})
L(w^) 是非负的。如果没有误分类点,损失函数值是0。而且,误分类点越少,误分类点离超平面越近,损失函数值越小,在误分类时是参数
w
^
widehat{w}
w
的线性函数,在正确分类时是0。因此,给定训练数据集,损失函数
L
(
w
^
)
L(hat{w})
L(w^) 是
w
^
hat{w}
w^ 的连续可导函数。
算法:
感知机学习算法是对一下最优化问题的算法,给定训练数据集
T
=
{
(
x
^
1
,
y
1
)
,
(
x
^
2
,
y
2
)
,
⋯
,
(
x
^
N
,
y
N
)
}
T=left{left(hat{x}_{1}, y_{1}right),left(hat{x}_{2}, y_{2}right), cdots,left(hat{x}_{N}, y_{N}right)right}
T={(x^1,y1),(x^2,y2),⋯,(x^N,yN)}
其中
x
^
i
∈
R
n
+
1
hat{x}_{i} in R^{n+1}
x^i∈Rn+1, 求参数
w
^
hat{w}
w^ 使其为以下损失函数极小化问题的解
L
(
w
^
)
=
∑
x
^
i
∈
M
(
y
^
i
−
y
i
)
w
^
T
x
^
i
L(hat{w})=sum_{hat{x}_{i} in M}left(hat{y}_{i}-y_{i}right) hat{w}^{T} hat{x}_{i}
L(w^)=x^i∈M∑(y^i−yi)w^Tx^i
其中
M
M
M 为误分类点的集合。
感知机学习算法是误分类驱动的,具体采用随机梯度下降法。首先,任意选取一个超平面
w
^
0
T
x
^
=
0
hat{w}_{0}^{T} hat{x}=0
w^0Tx^=0 用梯度下降法不断地极小化损失函数
L
(
w
^
)
L(hat{w})
L(w^) ,极小化过程中不是一次是
M
M
M 中所有误分类点的梯度下降,而是一次随机选取一个误分类点使其梯度下降。已知损失函数的梯度为
∇
L
(
w
^
)
=
∂
L
(
w
^
)
∂
w
^
=
∂
∂
w
^
[
∑
x
^
i
∈
M
(
y
^
i
−
y
i
)
w
^
T
x
^
i
]
=
∑
x
^
i
∈
M
[
(
y
^
i
−
y
i
)
∂
∂
w
^
(
w
^
T
x
^
i
)
]
=
∑
x
^
i
∈
M
(
y
^
i
−
y
i
)
x
^
i
begin{aligned} nabla L(hat{w})=frac{partial L(hat{w})}{partial hat{w}} &=frac{partial}{partial hat{w}}left[sum_{hat{x}_{i} in M}left(hat{y}_{i}-y_{i}right) hat{w}^{T} hat{x}_{i}right] \ &=sum_{hat{x}_{i} in M}left[left(hat{y}_{i}-y_{i}right) frac{partial}{partial hat{w}}left(hat{w}^{T} hat{x}_{i}right)right] \ &=sum_{hat{x}_{i} in M}left(hat{y}_{i}-y_{i}right) hat{x}_{i} end{aligned}
∇L(w^)=∂w^∂L(w^)=∂w^∂[x^i∈M∑(y^i−yi)w^Tx^i]=x^i∈M∑[(y^i−yi)∂w^∂(w^Tx^i)]=x^i∈M∑(y^i−yi)x^i
那么随机选取一个误分类点
x
^
i
hat{x}_{i}
x^i 进行梯度下降可得参数
w
^
hat{w}
w^ 的更新公式为
w
^
←
w
^
+
Δ
w
^
hat{w} leftarrow hat{w}+Delta hat{w}
w^←w^+Δw^
Δ
w
^
=
−
η
∇
L
(
w
^
)
Delta hat{w}=-eta nabla L(hat{w})
Δw^=−η∇L(w^)
w
^
←
w
^
−
η
∇
L
(
w
^
)
widehat{w} leftarrow widehat{w}-eta nabla L(hat{w})
w
←w
−η∇L(w^)
w
^
←
w
^
−
η
(
y
^
i
−
y
i
)
x
^
i
=
w
^
+
η
(
y
i
−
y
^
i
)
x
^
i
hat{w} leftarrow hat{w}-etaleft(hat{y}_{i}-y_{i}right) hat{x}_{i}=hat{w}+etaleft(y_{i}-hat{y}_{i}right) hat{x}_{i}
w^←w^−η(y^i−yi)x^i=w^+η(yi−y^i)x^i
Δ
w
^
=
η
(
y
i
−
y
^
i
)
x
^
i
Delta hat{w}=etaleft(y_{i}-hat{y}_{i}right) hat{x}_{i}
Δw^=η(yi−y^i)x^i此式即为书中式(5.2)
其中
η
∈
(
0
,
1
)
eta in(0,1)
η∈(0,1) 称为称为学习率。
神经网络
模型结构
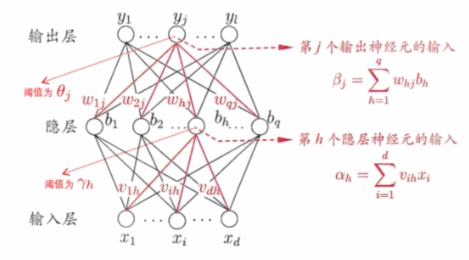
单隐藏前馈网络模型结构如下图所示
标准BP算法
给定一个训练样本
(
x
k
,
y
k
)
left(x_{k}, y_{k}right)
(xk,yk),假设模型输出为
y
^
k
=
(
y
^
1
k
,
y
^
2
k
,
…
,
y
^
l
k
)
hat{y}_{k}=left(hat{y}_{1}^{k}, hat{y}_{2}^{k}, ldots, hat{y}_{l}^{k}right)
y^k=(y^1k,y^2k,…,y^lk),则均方误差为
E
k
=
1
2
∑
j
=
1
l
(
y
^
j
k
−
y
j
k
)
2
E_{k}=frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2}
Ek=21j=1∑l(y^jk−yjk)2
此式即为书中式(5.4)
如果按照梯度下降法更新模型的参数,那么各个参数的更新公式为
w h j ← w h j + Δ w h j = w h j − η ∂ E k ∂ w h j w_{h j} leftarrow w_{h j}+Delta w_{h j}=w_{h j}-eta frac{partial E_{k}}{partial w_{h j}} whj←whj+Δwhj=whj−η∂whj∂Ek θ j ← θ j + Δ θ j = θ j − η ∂ E k ∂ θ j theta_{j} leftarrow theta_{j}+Delta theta_{j}=theta_{j}-eta frac{partial E_{k}}{partial theta_{j}} θj←θj+Δθj=θj−η∂θj∂Ek v i h ← v i h + Δ v i h = v i h − η ∂ E k ∂ v i h v_{i h} leftarrow v_{i h}+Delta v_{i h}=v_{i h}-eta frac{partial E_{k}}{partial v_{i h}} vih←vih+Δvih=vih−η∂vih∂Ek γ h ← γ h + Δ γ h = γ h − η ∂ E k ∂ γ h gamma_{h} leftarrow gamma_{h}+Delta gamma_{h}=gamma_{h}-eta frac{partial E_{k}}{partial gamma_{h}} γh←γh+Δγh=γh−η∂γh∂Ek
- 根据 E k E_{k} Ek 和 w h j w_{h j} whj 的函数链式关系
E k = 1 2 ∑ j = 1 l ( y ^ j k − y j k ) 2 y ^ j k = f ( β j − θ j ) β j = ∑ h = 1 q w h j b h begin{array}{c} E_{k}=frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2} \ hat{y}_{j}^{k}=fleft(beta_{j}-theta_{j}right) \ beta_{j}=sum_{h=1}^{q} w_{h j} b_{h} end{array} Ek=21∑j=1l(y^jk−yjk)2y^jk=f(βj−θj)βj=∑h=1qwhjbh
其中 f f f 为 Sigmoid 函数,所以有
∂ E k ∂ w h j = ∂ E k ∂ y ^ j k ⋅ ∂ y ^ j k ∂ β j ⋅ ∂ β j ∂ w h j frac{partial E_{k}}{partial w_{h j}}=frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial w_{h j}} ∂whj∂Ek=∂y^jk∂Ek⋅∂βj∂y^jk⋅∂whj∂βj
∂ E k ∂ y ^ j k = ∂ [ 1 2 ∑ j = 1 l ( y ^ j k − y j k ) 2 ] ∂ y ^ j k = 1 2 × 2 × ( y ^ j k − y j k ) × 1 = y ^ j k − y j k begin{aligned} frac{partial E_{k}}{partial hat{y}_{j}^{k}} &=frac{partialleft[frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2}right]}{partial hat{y}_{j}^{k}} \ &=frac{1}{2} times 2 timesleft(hat{y}_{j}^{k}-y_{j}^{k}right) times 1 \ &=hat{y}_{j}^{k}-y_{j}^{k} end{aligned} ∂y^jk∂Ek=∂y^jk∂[21∑j=1l(y^jk−yjk)2]=21×2×(y^jk−yjk)×1=y^jk−yjk
∂ y ^ j k ∂ β j = ∂ [ f ( β j − θ j ) ] ∂ β j = f ′ ( β j − θ j ) × 1 begin{aligned} frac{partial hat{y}_{j}^{k}}{partial beta_{j}} &=frac{partialleft[fleft(beta_{j}-theta_{j}right)right]}{partial beta_{j}} \ &=f^{prime}left(beta_{j}-theta_{j}right) times 1 end{aligned} ∂βj∂y^jk=∂βj∂[f(βj−θj)]=f′(βj−θj)×1
由于 f ′ ( x ) = f ( x ) ( 1 − f ( x ) ) f^{prime}(x)=f(x)(1-f(x)) f′(x)=f(x)(1−f(x))
∂ y ^ j k ∂ β j = f ( β j − θ j ) × [ 1 − f ( β j − θ j ) ] frac{partial hat{y}_{j}^{k}}{partial beta_{j}} =fleft(beta_{j}-theta_{j}right) timesleft[1-fleft(beta_{j}-theta_{j}right)right] ∂βj∂y^jk=f(βj−θj)×[1−f(βj−θj)]
∂ β j ∂ w h j = ∂ ( ∑ h = 1 q w h j b h ) ∂ w h j = b h begin{aligned} frac{partial beta_{j}}{partial w_{h j}} &=frac{partialleft(sum_{h=1}^{q} w_{h j} b_{h}right)}{partial w_{h j}} \ &=b_{h} end{aligned} ∂whj∂βj=∂whj∂(∑h=1qwhjbh)=bh
令 g j = − ∂ E k ∂ y ^ j k ⋅ ∂ y ^ j k ∂ β j = − ( y ^ j k − y j k ) ⋅ y ^ j k ( 1 − y ^ j k ) = y ^ j k ( 1 − y ^ j k ) ( y j k − y ^ j k ) g_{j}=-frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}}=-left(hat{y}_{j}^{k}-y_{j}^{k}right) cdot hat{y}_{j}^{k}left(1-hat{y}_{j}^{k}right)=hat{y}_{j}^{k}left(1-hat{y}_{j}^{k}right)left(y_{j}^{k}-hat{y}_{j}^{k}right) gj=−∂y^jk∂Ek⋅∂βj∂y^jk=−(y^jk−yjk)⋅y^jk(1−y^jk)=y^jk(1−y^jk)(yjk−y^jk)
此式即为书中式(5.10)
Δ w h j = − η ∂ E k ∂ w h j = − η ∂ E k ∂ y ^ j k ∂ y ^ j k ∂ β j ⋅ ∂ β j ∂ w h j = η g j b h begin{aligned} Delta w_{h j} &=-eta frac{partial E_{k}}{partial w_{h j}} \ &=-eta frac{partial E_{k}}{partial hat{y}_{j}^{k}} frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial w_{h j}} \ &=eta g_{j} b_{h} quad end{aligned} Δwhj=−η∂whj∂Ek=−η∂y^jk∂Ek∂βj∂y^jk⋅∂whj∂βj=ηgjbh
此式即为书中式(5.11)
- 根据 E k E_{k} Ek 和 θ j theta_{j} θj 的函数链式关系
E k = 1 2 ∑ j = 1 l ( y ^ j k − y j k ) 2 y ^ j k = f ( β j − θ j ) begin{array}{c} E_{k}=frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2} \ hat{y}_{j}^{k}=fleft(beta_{j}-theta_{j}right) end{array} Ek=21∑j=1l(y^jk−yjk)2y^jk=f(βj−θj)
所以有
∂ E k ∂ θ j = ∂ E k ∂ y ^ j k ⋅ ∂ y ^ j k ∂ θ j = ( y ^ j k − y j k ) ⋅ ∂ y ^ j k ∂ θ j = ( y ^ j k − y j k ) ⋅ ∂ [ f ( β j − θ j ) ] ∂ θ j = ( y ^ j k − y j k ) ⋅ f ′ ( β j − θ j ) × − 1 = ( y j k − y ^ j k ) ⋅ f ′ ( β j − θ j ) begin{aligned} frac{partial E_{k}}{partial theta_{j}} &=frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial theta_{j}} \ &=left(hat{y}_{j}^{k}-y_{j}^{k}right) cdot frac{partial hat{y}_{j}^{k}}{partial theta_{j}}\ &=left(hat{y}_{j}^{k}-y_{j}^{k}right) cdot frac{partialleft[fleft(beta_{j}-theta_{j}right)right]}{partial theta_{j}}\ &=left(hat{y}_{j}^{k}-y_{j}^{k}right) cdot f^{prime}left(beta_{j}-theta_{j}right) times-1\ &=left(y_{j}^{k}-hat{y}_{j}^{k}right) cdot f^{prime}left(beta_{j}-theta_{j}right) end{aligned} ∂θj∂Ek=∂y^jk∂Ek⋅∂θj∂y^jk=(y^jk−yjk)⋅∂θj∂y^jk=(y^jk−yjk)⋅∂θj∂[f(βj−θj)]=(y^jk−yjk)⋅f′(βj−θj)×−1=(yjk−y^jk)⋅f′(βj−θj)
Δ θ j = − η ∂ E k ∂ θ j = − η ( y j k − y ^ j k ) y ^ j k ( 1 − y ^ j k ) = − η g j begin{aligned} Delta theta_{j} &=-etafrac{partial E_{k}}{partial theta_{j}} \ &=-etaleft(y_{j}^{k}-hat{y}_{j}^{k}right) hat{y}_{j}^{k}left(1-hat{y}_{j}^{k}right)\ &=-eta g_{j} end{aligned} Δθj=−η∂θj∂Ek=−η(yjk−y^jk)y^jk(1−y^jk)=−ηgj
此式即为书中式(5.12)
- 根据 E k E_{k} Ek 和 v i h v_{i h} vih 的函数链式关系
E k = 1 2 ∑ j = 1 l ( y ^ j k − y j k ) 2 y ^ j k = f ( β j − θ j ) β j = ∑ h = 1 q w h j b h b h = f ( α h − γ h ) α h = ∑ i = 1 d v i h x i begin{array}{c} E_{k}=frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2} \ {hat{y}_{j}^{k}}=fleft(beta_{j}-theta_{j}right) \ qquad begin{array}{c} beta_{j}=sum_{h=1}^{q} w_{h j} b_{h} \ b_{h}=fleft(alpha_{h}-gamma_{h}right) \ alpha_{h}=sum_{i=1}^{d} v_{i h} x_{i} end{array} end{array} Ek=21∑j=1l(y^jk−yjk)2y^jk=f(βj−θj)βj=∑h=1qwhjbhbh=f(αh−γh)αh=∑i=1dvihxi
其中 f f f 为 Sigmoid 函数,所以有
∂ E k ∂ v i h = ∑ j = 1 l ∂ E k ∂ y ^ j k ⋅ ∂ y ^ j k ∂ β j ⋅ ∂ β j ∂ b h ⋅ ∂ b h ∂ α h ⋅ ∂ α h ∂ v i h frac{partial E_{k}}{partial v_{i h}}=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot frac{partial b_{h}}{partial alpha_{h}} cdot frac{partial alpha_{h}}{partial v_{i h}} ∂vih∂Ek=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅∂αh∂bh⋅∂vih∂αh
∂ β j ∂ b h = ∂ ( ∑ h = i q w h j b h ) ∂ b h = w h j begin{aligned} frac{partial beta_{j}}{partial b_{h}} &=frac{partialleft(sum_{h=i}^{q} w_{h j} b_{h}right)}{partial b_{h}} \ &=w_{h j} end{aligned} ∂bh∂βj=∂bh∂(∑h=iqwhjbh)=whj
∂ b h ∂ α h = ∂ [ f ( α h − γ h ) ] ∂ α h = f ′ ( α h − γ h ) × 1 = f ( α h − γ h ) × [ 1 − f ( α h − γ h ) ] = b h ( 1 − b h ) begin{aligned} frac{partial b_{h}}{partial alpha_{h}} &=frac{partialleft[fleft(alpha_{h}-gamma_{h}right)right]}{partial alpha_{h}} \ &=f^{prime}left(alpha_{h}-gamma_{h}right) times 1 \ &=fleft(alpha_{h}-gamma_{h}right) timesleft[1-fleft(alpha_{h}-gamma_{h}right)right] \ &=b_{h}left(1-b_{h}right) end{aligned} ∂αh∂bh=∂αh∂[f(αh−γh)]=f′(αh−γh)×1=f(αh−γh)×[1−f(αh−γh)]=bh(1−bh)
∂
α
h
∂
v
i
h
=
∂
(
∑
i
=
1
d
v
i
h
x
i
)
∂
v
i
h
=
x
i
begin{aligned} frac{partial alpha_{h}}{partial v_{i h}} &=frac{partialleft(sum_{i=1}^{d} v_{i h} x_{i}right)}{partial v_{i h}} \ &=x_{i} end{aligned}
∂vih∂αh=∂vih∂(∑i=1dvihxi)=xi
令
e
h
=
−
∂
E
k
∂
α
h
=
−
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
∂
b
h
∂
α
h
=
b
h
(
1
−
b
h
)
∑
j
=
1
l
w
h
j
g
j
e_{h}=-frac{partial E_{k}}{partial alpha_{h}}=-sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot frac{partial b_{h}}{partial alpha_{h}}=b_{h}left(1-b_{h}right) sum_{j=1}^{l} w_{h j} g_{j}
eh=−∂αh∂Ek=−j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅∂αh∂bh=bh(1−bh)j=1∑lwhjgj
此式即为书中式(5.15)
Δ v i h = − η ∂ E k ∂ v i h = − η ∑ j = 1 l ∂ E k ∂ y ^ j k ⋅ ∂ y ^ j k ∂ β j ⋅ ∂ β j ∂ b h ⋅ ∂ b h ∂ α h ⋅ ∂ α h ∂ v i h = η e h x i begin{aligned} Delta v_{i h} &=-eta frac{partial E_{k}}{partial v_{i h}} \ &=-eta sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot frac{partial b_{h}}{partial alpha_{h}} cdot frac{partial alpha_{h}}{partial v_{i h}} \ &=eta e_{h} x_{i} quad end{aligned} Δvih=−η∂vih∂Ek=−ηj=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅∂αh∂bh⋅∂vih∂αh=ηehxi
此式即为书中式(5.13)
- 根据 E k E_{k} Ek 和 γ h gamma_{boldsymbol{h}} γh 的函数链式关系
E
k
=
1
2
∑
j
=
1
l
(
y
^
j
k
−
y
j
k
)
2
y
^
j
k
=
f
(
β
j
−
θ
j
)
β
j
=
∑
h
=
1
q
w
h
j
b
h
b
h
=
f
(
α
h
−
γ
h
)
begin{array}{c} E_{k}=frac{1}{2} sum_{j=1}^{l}left(hat{y}_{j}^{k}-y_{j}^{k}right)^{2} \ hat{y}_{j}^{k}=fleft(beta_{j}-theta_{j}right) \ qquad begin{array}{c} beta_{j}=sum_{h=1}^{q} w_{h j} b_{h} \ b_{h}=fleft(alpha_{h}-gamma_{h}right) end{array} end{array}
Ek=21∑j=1l(y^jk−yjk)2y^jk=f(βj−θj)βj=∑h=1qwhjbhbh=f(αh−γh)
其中
f
f
f 为 Sigmoid 函数,所以有
∂
E
k
∂
γ
h
=
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
∂
b
h
∂
γ
h
=
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
∂
[
f
(
α
h
−
γ
h
)
]
∂
γ
h
=
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
f
′
(
α
h
−
γ
h
)
⋅
(
−
1
)
=
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
f
(
α
h
−
γ
h
)
×
[
1
−
f
(
α
h
−
γ
h
)
]
⋅
(
−
1
)
=
∑
j
=
1
l
∂
E
k
∂
y
^
j
k
⋅
∂
y
^
j
k
∂
β
j
⋅
∂
β
j
∂
b
h
⋅
b
h
(
1
−
b
h
)
⋅
(
−
1
)
=
∑
j
=
1
l
g
j
⋅
w
h
j
⋅
b
h
(
1
−
b
h
)
=
e
h
begin{aligned} frac{partial E_{k}}{partial gamma_{h}} &=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot frac{partial b_{h}}{partial gamma_{h}} \ &=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot frac{partialleft[fleft(alpha_{h}-gamma_{h}right)right]}{partial gamma_{h}} \ &=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot f^{prime}left(alpha_{h}-gamma_{h}right) cdot(-1) \ &=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot fleft(alpha_{h}-gamma_{h}right) timesleft[1-fleft(alpha_{h}-gamma_{h}right)right] cdot(-1) \ &=sum_{j=1}^{l} frac{partial E_{k}}{partial hat{y}_{j}^{k}} cdot frac{partial hat{y}_{j}^{k}}{partial beta_{j}} cdot frac{partial beta_{j}}{partial b_{h}} cdot b_{h}left(1-b_{h}right) cdot(-1)\ &=sum_{j=1}^{l} g_{j} cdot w_{h j} cdot b_{h}left(1-b_{h}right)\ &=e_{h} end{aligned}
∂γh∂Ek=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅∂γh∂bh=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅∂γh∂[f(αh−γh)]=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅f′(αh−γh)⋅(−1)=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅f(αh−γh)×[1−f(αh−γh)]⋅(−1)=j=1∑l∂y^jk∂Ek⋅∂βj∂y^jk⋅∂bh∂βj⋅bh(1−bh)⋅(−1)=j=1∑lgj⋅whj⋅bh(1−bh)=eh
所以有
Δ
γ
h
=
−
η
∂
E
k
∂
γ
h
=
−
η
e
h
begin{aligned} Delta gamma_{h} &=-eta frac{partial E_{k}}{partial gamma_{h}} \ &=-eta e_{h} end{aligned}
Δγh=−η∂γh∂Ek=−ηeh
此式即为书中式(5.14)
最后
以上就是时尚自行车最近收集整理的关于西瓜书神经网络公式详细推导的全部内容,更多相关西瓜书神经网络公式详细推导内容请搜索靠谱客的其他文章。
发表评论 取消回复