文章目录
- 一、监督学习、分类方法、标注方法
- 二、模型
- 2.1 概率模型与非概率模型
- 2.2 判别模型与生成模型
- 2.3 模型特点
- 2.4 部分模型之间的关系
- 三、十大统计学习方法模型、策略与算法
- 3.1 感知机
- 3.2 KNN
- 3.3 朴素贝叶斯法
- 3.4 决策树
- 3.5 逻辑斯蒂回归和最大熵模型
- 3.5.1 逻辑斯蒂回归
- 3.5.2 最大熵模型
- 3.6 SVM
- 3.7 提升方法(boosting)
- 3.7.1 Adaboost
- 3.7.2 GBDT(梯度提升树)
- 3.8 GMM与EM算法
- 3.8.1 模型
- 3.8.2 策略:对数似然损失
- 3.8.3 算法:EM算法
- 3.8.4 EM算法流程
- 3.9 隐马尔科夫模型
- 3.9.1 模型
- 3.9.2 策略:极大似然估计,对数似然函数
- 3.9.3 算法:EM算法
- 3.9.4 预测:维特比算法
- 3.10 线性链条件随机场
- 3.10.1 模型:时序数据上的对数线性模型
- 3.10.2 策略:极大似然估计,对数似然函数
- 3.10.3 算法
- 3.10.4 预测:维特比算法
- 四、十大统计学习方法知识点汇总
一、监督学习、分类方法、标注方法
-
监督学习可以认为是学习一个模型,使它能对给定的输入预测相应的输出。监督学习包括分类、标注、回归;
-
分类问题是实例的特征向量到类标记的预测问题;
-
标注问题是从观测序列到标记序列(或状态序列)的预测问题;
-
可以认为分类问题是标注问题的特殊情况。分类问题中可能的预测结果是二类或多类。而标注问题中可能的预测结果是所有的标记序列,其数目是指数级的。
-
感知机、k近邻法、朴素贝叶斯、决策树是简单的分类方法,具有模型直观、方法简单、容易实现等特点;
-
逻辑斯蒂回归与最大熵模型、支持向量机、提升方法是更复杂但更有效地的分类方法,往往分类准确率更高;
-
隐马尔科夫模型、条件随机场是主要的标注方法。通常条件随机场的标注准确率更高。
二、模型
2.1 概率模型与非概率模型
分类问题和标注问题的预测模型都可以认为是表示从输入空间到输出空间的映射。它们可以写成条件概率分布 P ( Y ∣ X ) P(Y|X) P(Y∣X)或 决策函数 Y = f ( X ) Y = f(X) Y=f(X)的形式。前者表示给定输入条件下输出的概率模型,后者表示输入到输出的非概率模型。
- 概率模型:朴素贝叶斯、隐马尔科夫模型
- 非概率模型: 感知机、k近邻法、支持向量机、提升方法
- 概率模型and非概率模型:决策树、逻辑斯蒂回归与最大熵模型、条件随机场
2.2 判别模型与生成模型
- 判别模型:直接学习条件概率分布 P ( Y ∣ X ) P(Y|X) P(Y∣X)或决策函数 Y = f ( X ) Y = f(X) Y=f(X)的模型。感知机、k近邻法、决策树、逻辑斯蒂回归与最大熵模型、支持向量机、提升方法、条件随机场是判别模型;
- 首先学习联合概率分布 P ( X , Y ) P(X,Y) P(X,Y),从而求得条件概率分布 P ( Y ∣ X ) P(Y|X) P(Y∣X)的模型。朴素贝叶斯、隐马尔科夫模型是生成模型。可以使用非监督学习的方法学习生成模型。例如EM算法。
2.3 模型特点
- 决策树是定义在一般的特征空间上的,可以含有连续变量或离散变量;
- 感知机、支持向量机、k近邻法的特征空间是欧式空间(更一般地,是希尔伯特空间);
- 提升方法的模型是弱分类器的组合,弱分类器的特征空间就是提升方法模型的特征空间;
- 感知机模型是线性模型。逻辑斯蒂回归与最大熵模型、条件随机场是对数线性模型。k近邻法、决策树、支持向量机(包含核函数)、提升方法使用的是非线性模型。
2.4 部分模型之间的关系
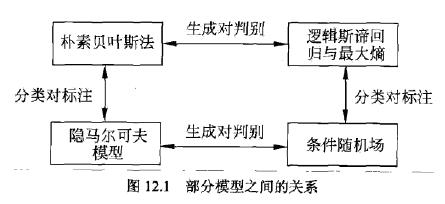
三、十大统计学习方法模型、策略与算法
3.1 感知机
详见感知机。
模型:
f
(
x
)
=
w
⋅
x
+
b
f(x) = wcdot x + b
f(x)=w⋅x+b
策略:损失函数极小化
m
i
n
L
(
w
,
b
)
=
−
∑
x
i
∈
M
y
i
(
w
⋅
x
i
+
b
)
minspace L(w,b) = -sum_{x_iin M}y_i(wcdot x_i + b)
min L(w,b)=−xi∈M∑yi(w⋅xi+b)
- 误分类点集合为M
算法:随机梯度下降法,
r
r
r为学习率
y
i
(
w
⋅
x
i
+
b
)
<
=
0
y_i(wcdot x_i + b) <= 0
yi(w⋅xi+b)<=0
w
=
w
+
r
×
y
i
⋅
x
i
w = w + r times y_icdot x_i
w=w+r×yi⋅xi
b
=
b
+
r
×
y
i
b = b + r times y_i
b=b+r×yi
3.2 KNN
详见KNN。
模型:计算距离
常用距离度量方式: 闵可夫斯基距离 “minkowski”也称作
L
p
L_p
Lp距离
L
p
=
[
∑
i
=
1
n
∣
x
i
−
y
i
∣
p
]
1
/
p
L_p = [sum_{i=1}^n|x_i - y_i|^p]^{1/p}
Lp=[i=1∑n∣xi−yi∣p]1/p
- p = 1 p = 1 p=1时称为曼哈顿距离 “manhattan”
- p = 2 p = 2 p=2时称为欧式距离 “euclidean”
- p = ∞ p = infty p=∞时称为切比雪夫距离“chebyshev”
策略:如果一个样本在特征空间中的k个最相邻的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性。
y
=
a
r
g
m
a
x
c
j
∑
x
i
∈
N
k
(
x
)
I
(
y
i
=
C
j
)
i
=
1
,
2
,
…
,
N
,
j
=
1
,
2
,
…
,
K
y = argspace max_{c_j} sum_{x_iin N_k(x)}space I(y_i = C_j) spacespace i = 1,2,…,N,space j = 1,2,…,K
y=arg maxcjxi∈Nk(x)∑ I(yi=Cj) i=1,2,…,N, j=1,2,…,K
算法:kd树搜索
3.3 朴素贝叶斯法
详见朴素贝叶斯法。
3.3.1 模型:贝叶斯定理
条件独立假设:用于分类的特征在类确定的条件下都是条件独立的。
P
(
Y
=
c
k
∣
X
=
x
)
=
P
(
Y
=
c
k
)
P
(
X
=
x
∣
Y
=
c
k
)
P
(
X
=
x
)
=
P
(
Y
=
c
k
)
∏
j
P
(
X
(
j
)
=
x
(
j
)
∣
Y
=
c
k
)
P
(
X
=
x
)
P(Y =c_k|X=x) = P(Y =c_k)frac {P(X=x|Y =c_k)}{P(X=x)} = P(Y =c_k)frac {prod_jP(X^{(j)} = x^{(j)}|Y = c_k)}{P(X=x)}
P(Y=ck∣X=x)=P(Y=ck)P(X=x)P(X=x∣Y=ck)=P(Y=ck)P(X=x)∏jP(X(j)=x(j)∣Y=ck)
求解
a
r
g
m
a
x
c
k
P
(
Y
=
c
k
∣
X
=
x
)
argspace max_{c_k}P(Y =c_k|X=x)
arg maxckP(Y=ck∣X=x)对于Y取每一个类时
P
(
X
=
x
)
P(X=x)
P(X=x)都是一样。也就是说后续在求解最优化时主要求解
P
(
Y
=
c
k
)
P(Y =c_k)
P(Y=ck)和
∏
j
P
(
X
(
j
)
=
x
(
j
)
∣
Y
=
c
k
)
prod_jP(X^{(j)} = x^{(j)}|Y = c_k)
∏jP(X(j)=x(j)∣Y=ck)即可。
3.3.2 策略:对数似然损失
3.3.3 算法:概率计算
- 极大似然估计下:
先验概率:
P
(
Y
=
c
k
)
=
∑
i
=
1
N
I
(
y
i
=
c
k
)
N
,
k
=
1
,
2
,
…
,
K
P(Y=c_k) = frac {sum_{i=1}^NI(y_i = c_k)}{N},k = 1,2,…,K
P(Y=ck)=N∑i=1NI(yi=ck),k=1,2,…,K
特征
j
space jspace
j 的类条件概率:第
j
space jspace
j 个特征
x
(
j
)
x^{(j)}
x(j)可能取值的集合为
{
a
j
1
,
a
j
2
,
…
,
a
j
S
j
}
{a_{j1},a_{j2},…,a_{jS_j}}
{aj1,aj2,…,ajSj}
P
(
X
(
j
)
=
a
j
l
∣
Y
=
c
k
)
=
∑
i
=
1
N
I
(
x
i
(
j
)
=
a
j
l
,
y
i
=
c
k
)
∑
i
=
1
N
I
(
y
i
=
c
k
)
,
j
=
1
,
2
,
…
,
n
;
l
=
1
,
2
,
…
,
S
j
;
k
=
1
,
2
,
…
,
K
P(X^{(j)} = a_{jl}|Y = c_k) = frac {sum_{i=1}^NI(x_i^{(j)} = a_{jl},y_i = c_k)}{sum_{i=1}^NI(y_i = c_k)},j = 1,2,…,n;l = 1,2,…,S_j;k = 1,2,…,K
P(X(j)=ajl∣Y=ck)=∑i=1NI(yi=ck)∑i=1NI(xi(j)=ajl,yi=ck),j=1,2,…,n;l=1,2,…,Sj;k=1,2,…,K
- 贝叶斯估计
P ( Y = c k ) = ∑ i = 1 N I ( y i = c k ) + λ N + K λ P(Y = c_k) = dfrac {sum_{i=1}^N{space I(y_i = c_k)} + lambda}{N + Klambda} P(Y=ck)=N+Kλ∑i=1N I(yi=ck)+λ
P ( x ( j ) = a j l ∣ Y = c k ) = ∑ i = 1 N I ( y i = c k , x i ( j ) = a j l ) + λ ∑ i = 1 N I ( y i = c k ) + S j λ P(x^{(j)} = a_jl|Y = c_k) = dfrac {sum_{i=1}^N{space I(y_i = c_k,x_i^{(j)} = a_{jl})} + lambda}{sum_{i=1}^N{space I(y_i = c_k)} + S_jlambda} P(x(j)=ajl∣Y=ck)=∑i=1N I(yi=ck)+Sjλ∑i=1N I(yi=ck,xi(j)=ajl)+λ
λ = 0 lambda = 0 λ=0时就为极大似然估计。常取 λ = 1 lambda = 1 λ=1,这时称为拉普拉斯平滑(Laplace smoothing)。
3.4 决策树
详见决策树。
3.4.1 特征选择:使用某特征对数据集划分之后,各数据子集的纯度要比划分前的数据集D的纯度高(也就是不确定性要比划分前数据集D的不确定性低)。
特征选择的方法:
- 信息增益,ID3采用
- 信息增益比,C4.5采用
- GiniIndex,CART分类采用
- 平方误差最小化准则,CART回归采用
3.4.2 决策树的生成
输入:训练数据集D,特征集A,阈值 ε varepsilon ε
输出:决策树T
-
ID3(或ID4.5)决策树生成:计算A中各特征对D的信息增益(或信息增益比),选择信息增益(或信息增益比)最大的特征 A g A_g Ag;对 A g A_g Ag的每一可能取值 a i a_i ai,依 A g = a i A_g = a_i Ag=ai将D分割为若干非空子集 D i D_i Di,将 D i D_i Di中实例数最大的类作为标记,构建子结点,由结点及其子结点构成树T,返回T。
-
CART分类树的生成:在所有可能的特征A以及他们所有可能的切分点a中,选择基尼指数最小的特征及其对应的切分点为最优特征和最优切分点。最优特征和最优切分点,从现结点生成两个子结点,将训练数据集依特征分配到两个子结点中去。
上面两种生成方法不同之处在于第一种生成是选出最优的特征,第二种生成是选出最优特征并找出最优切分点。这也是CART决策树相较之的优点所在。
- CART回归树生成
step1:选择最优切分变量j和切分点s,求解:
m
i
n
∑
j
,
s
(
m
i
n
c
1
∑
x
i
∈
R
1
(
j
,
s
)
(
y
i
−
c
1
)
2
+
m
i
n
c
2
∑
x
i
∈
R
2
(
j
,
s
)
(
y
i
−
c
2
)
2
)
min sum_{j,s}(min_{c_1}sum_{x_iin R_1(j,s)}(y_i-c_1)^2 + min_{c_2}sum_{x_iin R_2space (j,s)}(y_i-c_2)^2)
minj,s∑(minc1xi∈R1(j,s)∑(yi−c1)2+minc2xi∈R2 (j,s)∑(yi−c2)2)
遍历变量j,对固定的切分变量j扫描切分点s,选择使上式达到最小值的对
(
j
,
s
)
(j,s)
(j,s)。
step2:用选定的对
(
j
,
s
)
(j,s)
(j,s)划分区域并决定相应的输出值:
R
1
(
j
,
s
)
=
{
x
∣
x
(
j
)
<
=
s
}
,
R
2
(
j
,
s
)
=
{
x
∣
x
(
j
)
>
s
}
R_1(j,s) = {x|x^{(j)} <=s},R_2(j,s) = {x|x^{(j)} > s}
R1(j,s)={x∣x(j)<=s},R2(j,s)={x∣x(j)>s}
c
1
^
=
a
v
e
(
y
i
∣
x
i
∈
R
1
(
j
,
s
)
)
,
c
2
^
=
a
v
e
(
y
i
∣
x
i
∈
R
2
(
j
,
s
)
)
hat{c_1} = ave(y_i|x_iin R_1(j,s)),space hat{c_2} = ave(y_i|x_iin R_2(j,s))
c1^=ave(yi∣xi∈R1(j,s)), c2^=ave(yi∣xi∈R2(j,s))
3.4.3 决策树的剪枝
-
决策树的生成算法容易构建过于复杂的决策树,产生过拟合。
-
决策树的剪枝:在决策树学习中将已生成的树进行简化的过程称为剪枝(pruning)。具体地,剪枝从已生成的树上裁掉一些子树或叶结点,并将其根结点或父结点作为新的叶结点,从而简化分类树模型.
-
决策树的剪枝往往通过极小化决策树整体的损失函数(loss fimction)或代价函数( cost function)来实现。
ID3(或ID4.5)剪枝方法:
设树T的叶结点个数为|T|, t是树T的叶结点,该叶结点有
N
t
N_t
Nt个样本点,其中k类的样本点有
N
t
k
N_{tk}
Ntk个,k=1,2,…,K,
H
t
(
T
)
H_t(T)
Ht(T)为叶结点t上的经验嫡,
α
≥
0
alpha geq 0
α≥0为参数,则决策树学习的损失函数可以定义为:
C
α
(
T
)
=
∑
t
=
1
∣
T
∣
N
t
H
t
(
T
)
+
α
∣
T
∣
=
−
∑
t
=
1
∣
T
∣
∑
k
=
1
K
N
t
k
l
o
g
N
t
k
N
t
+
α
∣
T
∣
C_{alpha} (T) = sum_{t=1}^{|T|}N_t H_t(T) + alpha |T| = -sum_{t=1}^{|T|}sum_{k=1}^K N_{tk}logdfrac{N_{tk}}{N_t} + alpha |T|
Cα(T)=t=1∑∣T∣NtHt(T)+α∣T∣=−t=1∑∣T∣k=1∑KNtklogNtNtk+α∣T∣
3.5 逻辑斯蒂回归和最大熵模型
详见逻辑斯蒂回归和最大熵模型。
3.5.1 逻辑斯蒂回归
模型:
z
=
w
⋅
x
+
b
z = wcdot x + b
z=w⋅x+b
y
=
h
θ
(
x
)
=
s
i
g
m
o
i
d
(
z
)
=
1
1
+
e
−
z
y = h_{theta}(x) = sigmoid(z) = dfrac{1}{1+ e^{-z}}
y=hθ(x)=sigmoid(z)=1+e−z1
策略:极大似然估计
似然函数
L
(
θ
)
=
∏
i
=
1
N
[
h
θ
(
x
(
i
)
)
]
y
(
i
)
[
1
−
h
θ
(
x
(
i
)
)
]
(
1
−
y
(
i
)
)
L(theta) = prod_{i=1}^Nspace[h_{theta}(x^{(i)})]^{y^{(i)}}space[1 - h_{theta}(x^{(i)})]^{(1- y^{(i)}space )}
L(θ)=i=1∏N [hθ(x(i))]y(i) [1−hθ(x(i))](1−y(i) )
对数损失函数
J
=
−
1
N
l
(
θ
)
=
−
1
N
∑
i
=
1
N
[
y
(
i
)
l
o
g
h
θ
(
x
(
i
)
)
+
(
1
−
y
(
i
)
)
l
o
g
(
1
−
h
θ
(
x
(
i
)
)
)
]
J = -dfrac{1}{N}l(theta) = -dfrac{1}{N}sum_{i=1}^Nspace [y^{(i)}logspace h_{theta}(x^{(i)}) + (1- y^{(i)})log(1 - h_{theta}(x^{(i)}))]
J=−N1l(θ)=−N1i=1∑N [y(i)log hθ(x(i))+(1−y(i))log(1−hθ(x(i)))]
算法:梯度下降
d
w
=
∂
J
∂
h
θ
(
x
(
i
)
)
∂
h
θ
(
x
(
i
)
)
∂
z
∂
z
∂
w
=
1
N
∑
i
=
1
N
[
h
θ
(
x
(
i
)
)
−
y
(
i
)
]
x
(
i
)
dw = dfrac{partial J}{partial h_{theta}(x^{(i)})} dfrac{partial h_{theta}(x^{(i)})}{partial z}dfrac{partial z}{partial w} = dfrac{1}{N}sum_{i=1}^Nspace[h_{theta}(x^{(i)}) - y^{(i)}]x^{(i)}
dw=∂hθ(x(i))∂J∂z∂hθ(x(i))∂w∂z=N1i=1∑N [hθ(x(i))−y(i)]x(i)
d
b
=
∂
J
∂
h
θ
(
x
(
i
)
)
∂
h
θ
(
x
(
i
)
)
∂
z
∂
z
∂
b
=
1
N
∑
i
=
1
N
[
h
θ
(
x
(
i
)
)
−
y
(
i
)
]
db = dfrac{partial J}{partial h_{theta}(x^{(i)})} dfrac{partial h_{theta}(x^{(i)})}{partial z}dfrac{partial z}{partial b} = dfrac{1}{N}sum_{i=1}^Nspace[h_{theta}(x^{(i)}) - y^{(i)}]
db=∂hθ(x(i))∂J∂z∂hθ(x(i))∂b∂z=N1i=1∑N [hθ(x(i))−y(i)]
w
=
w
−
α
×
d
w
w = w - alphatimes dw
w=w−α×dw
b
=
b
−
α
×
d
b
b = b - alphatimes db
b=b−α×db
3.5.2 最大熵模型
模型:
条件概率分布
P
(
Y
∣
X
)
P(Y | X)
P(Y∣X)上的条件熵为:
H
(
P
)
=
−
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
l
o
g
P
(
y
∣
x
)
H(P)=−sum_{x,y}tilde{P}(x) P(y | x)logP(y | x)
H(P)=−x,y∑P~(x)P(y∣x)logP(y∣x)
策略:选择条件熵最大的模型
m
a
x
P
∈
C
H
(
P
)
=
−
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
l
o
g
P
(
y
∣
x
)
max_{Pin{bf C}}spacespace H(P)=−sum_{x,y}tilde{P}(x) P(y | x)logP(y | x)
maxP∈C H(P)=−x,y∑P~(x)P(y∣x)logP(y∣x)
s
.
t
.
E
P
(
f
i
)
=
E
P
~
(
f
i
)
,
i
=
1
,
2
,
.
.
.
,
n
s.t.spacespace E_P(f_i)=E_{tilde{P}}(f_i), i=1,2,...,n
s.t. EP(fi)=EP~(fi),i=1,2,...,n
∑
y
P
(
y
∣
x
)
=
1
sum_yP(y | x)=1
y∑P(y∣x)=1
用特征函数
f
(
x
,
y
)
f(x,y)
f(x,y)描述输入
x
xspace
x 和
输
出
y
输出yspace
输出y 之间的某一个事实。其定义是:
f
(
x
,
y
)
=
{
1
,
x
与
y
满
足
某
一
事
实
0
,
o
t
h
e
r
v
a
l
u
e
s
f(x,y)=begin{cases} 1, & x与y满足某一事实\ 0, & other values end{cases}
f(x,y)={1,0,x与y满足某一事实other values
特征函数
f
(
x
,
y
)
f(x,y)
f(x,y)关于经验分布
P
~
(
X
,
Y
)
tilde{P}(X,Y)
P~(X,Y)的期望值,用
E
P
~
(
f
)
E_{tilde{P}}(f)
EP~(f)表示。
E
P
~
(
f
)
=
∑
x
,
y
P
~
(
x
,
y
)
f
(
x
,
y
)
=
∑
x
,
y
P
~
(
x
)
P
~
(
y
∣
x
)
f
(
x
,
y
)
E_{tilde{P}}(f) = sum_{x,y}tilde{P}(x,y)f(x,y) = sum_{x,y}tilde{P}(x)tilde{P}(y|x)f(x,y)
EP~(f)=x,y∑P~(x,y)f(x,y)=x,y∑P~(x)P~(y∣x)f(x,y)
特征函数
f
(
x
,
y
)
f(x,y)
f(x,y)关于模型
P
(
Y
∣
X
)
P(Y|X)
P(Y∣X)与经验分布
P
~
(
X
)
tilde{P}(X)
P~(X)的期望值,用
E
P
(
f
)
E_{P}(f)
EP(f)表示。
E
P
(
f
)
=
∑
x
,
y
P
~
(
x
)
P
(
y
∣
x
)
f
(
x
,
y
)
E_{P}(f) = sum_{x,y}tilde{P}(x)P(y|x)f(x,y)
EP(f)=x,y∑P~(x)P(y∣x)f(x,y)
算法:
- 通用迭代尺度法(GIS: Generalized Iterative Scaling)。
- 改进的迭代尺度法(IIS: Improved Iterative Scaling)。
- 梯度下降算法
- 拟牛顿法(牛顿法)
最大熵原理:承认已知事物(知识);对未知事物不做任何假设,没有任何偏见。
两个角度认识未知事物:
- 最大熵模型:对不确定度的无偏分配;
- 最大似然估计:对知识的无偏理解。
3.6 SVM
详见SVM。
模型:分类超平面
策略:核技巧,软间隔最大化
max
w
,
b
γ
^
∣
∣
w
∣
∣
s
.
t
.
y
i
(
w
x
i
+
b
)
≥
γ
^
,
i
=
1
,
2
,
⋯
 
,
N
begin{aligned} max_{w,b}spacespace & dfrac{hat{gamma}}{||w||} \ s.t. spacespacespacespace & y_ileft({w}x_i + {b}right) geq hat{gamma},space i = 1,2,cdots ,N end{aligned}
w,bmax s.t. ∣∣w∣∣γ^yi(wxi+b)≥γ^, i=1,2,⋯,N
做两点变换,但不影响最优化问题:
- 取 γ ^ = 1 {hat{gamma}} = 1 γ^=1,因为对于任何一个超平面都可以使得其函数间隔为1,只要对w和b做相应的放大和缩小就行,另外取1可以使得计算最简单,当然不能为了简单取0;
- 最大化 1 ∣ ∣ w ∣ ∣ dfrac{1}{||w||} ∣∣w∣∣1和最小化 1 2 ∣ ∣ w ∣ ∣ 2 dfrac{1}{2}||w||^2 21∣∣w∣∣2是等价的。是为了算法求解简单,凸二次优化有成熟的工具,这样一求导数就只有 w w w了。
则最优化问题等价为:
min
w
,
b
1
2
∣
∣
w
∣
∣
2
s
.
t
.
1
−
y
i
(
w
x
i
+
b
)
≤
0
,
i
=
1
,
2
,
⋯
 
,
N
begin{aligned} min_{w,b}spacespace & dfrac{1}{2}||w||^2 \ s.t. spacespacespace & 1 - y_ileft({w}x_i + {b}right) leq 0,space i = 1,2,cdots ,N end{aligned}
w,bmin s.t. 21∣∣w∣∣21−yi(wxi+b)≤0, i=1,2,⋯,N
线性不可分意味着某些样本点
(
x
i
,
y
i
)
(x_i,y_i)
(xi,yi)不能满足函数间隔大于等于1的约束条件。为了解决这个问题,可以对每个样本点
(
x
i
,
y
i
)
(x_i,y_i)
(xi,yi)引进一个松弛变量
ξ
i
≥
0
xi_i geq 0
ξi≥0,使函数间隔加上松弛变量大于等于1.这样,约束条件变为:
y
i
(
w
x
i
+
b
)
≥
1
−
ξ
i
,
i
=
1
,
2
,
⋯
 
,
N
y_ileft({bf w}{bf x_i} + {b}right) geq 1 - xi_i,space i = 1,2,cdots ,N
yi(wxi+b)≥1−ξi, i=1,2,⋯,N
对于每一特异点虽然也让它入伙,但是需要支付额外的代价,即松弛变量
ξ
i
×
1
xi_i times 1
ξi×1,目标函数由原来的
1
2
∣
∣
w
∣
∣
2
dfrac {1}{2}||w||^2
21∣∣w∣∣2变成:
1
2
∣
∣
w
∣
∣
2
+
C
∑
i
=
1
N
ξ
i
dfrac {1}{2}||{bf w}||^2 + C sum_{i=1}^N xi_i
21∣∣w∣∣2+Ci=1∑Nξi
算法:序列最小最优算法(SMO)
3.7 提升方法(boosting)
详见提升方法(boosting)。
3.7.1 Adaboost
模型:加法模型,最终的强分类器是若干个弱分类器加权平均而得到的,基学习器类别不定。
G
(
x
)
=
s
i
g
n
(
f
(
x
)
)
=
s
i
g
n
(
∑
m
=
1
M
α
m
G
m
(
x
)
)
G(x) = sign(f(x)) = signleft( sum_{m=1}^M alpha_m G_m(x)right)
G(x)=sign(f(x))=sign(m=1∑MαmGm(x))
- G m ( x ) G_m(x) Gm(x)为第m个弱分类器, m = 1 , 2 , ⋯   , M m = 1,2,cdots , M m=1,2,⋯,M
- α m alpha_m αm为第m个弱分类器的权重系数
策略:极小化加法模型的指数损失。
第
m
m
m轮的强分类器
f
m
(
x
)
f_m(x)
fm(x)在训练数据集
T
T
T上的指数损失函数为:
a
r
g
min
∑
i
=
1
N
e
x
p
[
−
y
i
f
m
(
x
i
)
]
=
min
∑
i
=
1
N
e
x
p
[
−
y
i
(
f
m
−
1
(
x
i
)
+
α
m
G
m
(
x
i
)
)
]
=
min
α
,
G
∑
i
=
1
N
w
ˉ
m
,
i
e
x
p
[
−
α
m
y
i
G
m
(
x
i
)
)
]
begin{aligned} arg space & min sum_{i=1}^N exp[-y_i f_m(x_i)]\ = & min sum_{i=1}^N exp[-y_i (f_{m-1}(x_i) + alpha_m G_m(x_i))] \ = & min_{alpha,G} sum_{i=1}^N bar w_{m,i}space exp[ -alpha_m y_i G_m(x_i))] \ end{aligned}
arg ==mini=1∑Nexp[−yifm(xi)]mini=1∑Nexp[−yi(fm−1(xi)+αmGm(xi))]α,Gmini=1∑Nwˉm,i exp[−αmyiGm(xi))]
- w ˉ m , i = e x p [ − y i f m − 1 ( x i ) ] bar w_{m,i} = exp[-y_ispace f_{m-1}(x_i)] wˉm,i=exp[−yi fm−1(xi)]
- 因为 w ˉ m , i bar w_{m,i} wˉm,i既不依赖 α m alpha_m αm也不依赖于 G m ( x ) G_m(x) Gm(x),所以在第 m m m轮求最小化时可以当作固定值看待。这也解释了为什么可以使用前向分步算法作为优化求解算法。
- w ˉ m , i bar w_{m,i} wˉm,i依赖于 f m − 1 ( x i ) f_{m-1}(x_i) fm−1(xi),随着每一轮迭代而发生变化。
算法:前向分步学习算法,我们的算法是通过一轮轮的弱分类器学习,每一轮选择加权训练数据分类误差率最小的弱分类器,利用前一个弱分类器的结果来更新后一个弱分类器的训练集权重。
f
m
(
x
)
=
f
m
−
1
(
x
)
+
α
m
G
m
(
x
)
f_m(x) = f_{m-1}(x) + alpha_m G_m(x)
fm(x)=fm−1(x)+αmGm(x)
G
m
∗
(
x
)
=
a
r
g
min
G
∑
i
=
1
N
w
ˉ
m
,
i
I
(
y
i
̸
=
G
m
(
x
i
)
)
G_m^*(x) = argspace min_{G} sum_{i=1}^N bar w_{m,i}space I( y_i not= G_m(x_i))
Gm∗(x)=arg Gmini=1∑Nwˉm,i I(yi̸=Gm(xi))
α
m
∗
=
1
2
l
n
1
−
e
m
e
m
alpha_m^* = dfrac{1}{2}lndfrac{1-e_m}{e_m}
αm∗=21lnem1−em
其中
e
m
e_m
em:
e
m
=
∑
i
=
1
N
w
ˉ
m
,
i
I
(
y
i
̸
=
G
m
∗
(
x
i
)
)
∑
i
=
1
N
w
ˉ
m
,
i
=
∑
i
=
1
N
w
m
,
i
I
(
y
i
̸
=
G
m
∗
(
x
i
)
)
e_m = dfrac{sum_{i=1}^N bar w_{m,i} I(y_i not= G_m^*(x_i))}{sum_{i=1}^N bar w_{m,i}} = sum_{i=1}^N w_{m,i} I(y_i not= G_m^*(x_i))
em=∑i=1Nwˉm,i∑i=1Nwˉm,iI(yi̸=Gm∗(xi))=i=1∑Nwm,iI(yi̸=Gm∗(xi))
3.7.2 GBDT(梯度提升树)
模型:加法模型,基学习器为决策树。
f
M
(
x
)
=
f
0
(
x
)
+
∑
m
=
1
M
T
(
x
;
Θ
m
)
f_M(x) = f_0(x)+ sum_{m=1}^M T(x;Theta_m)
fM(x)=f0(x)+m=1∑MT(x;Θm)
策略:损失函数不定,根据不同的损失函数而得到不同的提升树
通过经验风险极小化确定下一棵决策树的参数
Θ
m
Theta_m
Θm
Θ
^
m
=
a
r
g
min
Θ
m
∑
i
=
1
N
L
(
y
i
,
f
m
−
1
(
x
i
)
+
T
(
x
i
;
Θ
m
)
)
hat Theta_m = argspace min_{Theta_m}sum_{i=1}^N L(y_i,f_{m-1}(x_i) + T(x_i;Theta_m))
Θ^m=arg Θmmini=1∑NL(yi,fm−1(xi)+T(xi;Θm))
算法:前向分步算法
3.8 GMM与EM算法
详见GMM与EM算法。
3.8.1 模型
P ( y ∣ θ ) = ∑ k = 1 K α k ϕ ( y ∣ θ k ) P(y|theta) = sum_{k=1}^K alpha_k phi(y|theta_k) P(y∣θ)=k=1∑Kαkϕ(y∣θk)
- α k alpha_k αk是系数, α k ≥ 0 , ∑ k = 1 K = 1 alpha_k geq 0,sum_{k=1}^K = 1 αk≥0,∑k=1K=1;
-
ϕ
(
y
∣
θ
k
)
phi(y|theta_k)
ϕ(y∣θk)是高斯分布密度,
θ
k
=
(
μ
k
,
σ
k
2
)
theta_k = (mu_k,sigma_k^2)
θk=(μk,σk2)
ϕ ( y ∣ θ k ) = 1 2 π σ k e x p ( − ( y − μ k ) 2 2 σ k 2 ) phi(y|theta_k) = dfrac{1}{sqrt{2pi}space sigma_k}exp left( -dfrac{(y - mu_k)^2}{2sigma_k^2}right) ϕ(y∣θk)=2π σk1exp(−2σk2(y−μk)2)
称为第k个分模型。
3.8.2 策略:对数似然损失
观测数据
y
j
y_j
yj来自第k个分模型的数据是未知的,
k
=
1
,
2
,
⋯
 
,
K
k = 1,2,cdots ,K
k=1,2,⋯,K,以隐变量
γ
j
k
gamma_{jk}
γjk表示,其定义如下:
γ
j
k
=
{
1
,
第j个观测来自第k个分模型
0
,
否则
j
=
1
,
2
,
⋯
 
,
N
;
k
=
1
,
2
,
⋯
 
,
K
gamma_{jk} = begin{cases} 1, & text{第j个观测来自第k个分模型} \[2ex] 0, & text{否则} end{cases}\ j=1,2,cdots ,N;k=1,2,cdots ,K
γjk=⎩⎨⎧1,0,第j个观测来自第k个分模型否则j=1,2,⋯,N;k=1,2,⋯,K
γ
j
k
gamma_{jk}
γjk是0-1随机变量。
完全数据的似然函数:
P
(
y
,
γ
∣
θ
)
=
∏
j
=
1
N
P
(
y
j
,
γ
j
1
,
γ
j
2
,
⋯
 
,
γ
j
K
∣
θ
)
=
∏
j
=
1
N
∏
k
=
1
K
[
α
k
ϕ
(
y
j
∣
θ
k
)
]
γ
j
k
=
∏
k
=
1
K
α
k
n
k
∏
j
=
1
N
[
ϕ
(
y
j
∣
θ
k
)
]
γ
j
k
=
∏
k
=
1
K
α
k
n
k
∏
j
=
1
N
[
1
2
π
σ
k
e
x
p
(
−
(
y
−
μ
k
)
2
2
σ
k
2
)
]
γ
j
k
begin{aligned}P(y,gamma|theta) & = prod_{j=1}^N P(y_j,gamma_{j1},gamma_{j2},cdots,gamma_{jK}|theta) = prod_{j=1}^N prod_{k=1}^K [alpha_k phi(y_j|theta_k)]^{gamma_{jk}} = prod_{k=1}^K alpha_k^{n_k} prod_{j=1}^N [phi(y_j|theta_k)]^{gamma_{jk}} \ & = prod_{k=1}^K alpha_k^{n_k} prod_{j=1}^N left[ dfrac{1}{sqrt{2pi}spacesigma_k}exp left( -dfrac{(y - mu_k)^2}{2sigma_k^2}right)right]^{gamma_{jk}} end{aligned}
P(y,γ∣θ)=j=1∏NP(yj,γj1,γj2,⋯,γjK∣θ)=j=1∏Nk=1∏K[αkϕ(yj∣θk)]γjk=k=1∏Kαknkj=1∏N[ϕ(yj∣θk)]γjk=k=1∏Kαknkj=1∏N[2π σk1exp(−2σk2(y−μk)2)]γjk
其中,
n
k
=
∑
j
=
1
N
γ
j
k
,
∑
k
=
1
K
n
k
=
N
n_k = sum_{j=1}^N gamma_{jk},space sum_{k=1}^K n_k = N
nk=∑j=1Nγjk, ∑k=1Knk=N。
那么,完全数据的对数似然函数为
l
n
P
(
y
,
γ
∣
θ
)
=
∑
k
=
1
K
n
k
l
n
α
k
+
∑
k
=
1
K
∑
j
=
1
N
γ
j
k
[
l
n
(
1
2
π
)
−
l
n
σ
k
−
1
2
σ
k
2
(
y
j
−
μ
k
)
2
]
ln P(y,gamma|theta) = sum_{k=1}^K n_k lnalpha_k + sum_{k=1}^Ksum_{j=1}^N gamma_{jk}left[ lnleft( dfrac{1}{sqrt{2pi}} right)- lnsigma_k - dfrac{1}{2sigma_k^2}(y_j - mu_k)^2 right]
lnP(y,γ∣θ)=k=1∑Knklnαk+k=1∑Kj=1∑Nγjk[ln(2π1)−lnσk−2σk21(yj−μk)2]
3.8.3 算法:EM算法
3.8.4 EM算法流程
输入:观测变量数据 Y Y Y,隐变量数据 Z Z Z,联合分布 P ( Y , Z ∣ θ ) P(Y,Z|theta) P(Y,Z∣θ),条件分布 P ( Z ∣ Y , θ ) P(Z|Y,theta) P(Z∣Y,θ);
输出:模型参数 θ theta θ。
(1)选择参数的初值 θ ( 0 ) theta^{(0)} θ(0),开始迭代;初值可以任意选择,但需注意EM算法对初值是敏感的。
(2)E步:记 θ ( i ) theta^{(i)} θ(i)为第 i i i次迭代参数 θ theta θ的估计值,在第 i + 1 i + 1 i+1次迭代的E步,计算
Q ( θ , θ ( i ) ) = ∑ Z P ( Z ∣ Y , θ ( i ) ) l n P ( Y , Z ∣ θ ) = E Z [ l n P ( Y , Z ∣ θ ) ∣ Y , θ ( i ) ] Q(theta,theta^{(i)}) = sum_{Z}P(Z|Y,theta^{(i)})lnP(Y,Z|theta) = E_Z[lnP(Y,Z|theta)|Y,theta^{(i)}] Q(θ,θ(i))=Z∑P(Z∣Y,θ(i))lnP(Y,Z∣θ)=EZ[lnP(Y,Z∣θ)∣Y,θ(i)]
- 上式的函数 Q ( θ , θ ( i ) ) Q(theta,theta^{(i)}) Q(θ,θ(i))是EM算法的核心,称为 Q Q Q函数。
- 需要计算 P ( Z ∣ Y , θ ( i ) ) P(Z|Y,theta^{(i)}) P(Z∣Y,θ(i)),即在给定观测数据 Y Y Y和当前的参数估计 θ ( i ) theta^{(i)} θ(i)下隐变量数据 Z Z Z的条件概率分布,作为隐变量的现估计值。
- Q Q Q函数:完全数据的对数似然函数 l n P ( Y , Z ∣ θ ) lnP(Y,Z|theta) lnP(Y,Z∣θ)关于在给定观测数据 Y Y Y和当前参数 θ ( i ) theta^{(i)} θ(i)下对未观测数据 Z Z Z的条件概率分布 P ( Z ∣ Y , θ ( i ) ) P(Z|Y,theta^{(i)}) P(Z∣Y,θ(i))的期望称为 Q Q Q函数。
(3)M步:求使 Q ( θ , θ ( i ) ) Q(theta,theta^{(i)}) Q(θ,θ(i))极大化的 θ theta θ,确定第 i + 1 i+1 i+1次迭代的参数的估计值 θ ( i + 1 ) theta^{(i + 1)} θ(i+1)
θ ( i + 1 ) = a r g max θ Q ( θ , θ ( i ) ) theta^{(i+1)} = argspace max_{theta} Q(theta,theta^{(i)}) θ(i+1)=arg θmaxQ(θ,θ(i))
(4)重复第(2)步和第(3)步,直到收敛。给出停止迭代的条件,一般是对较小的正数 ϵ 1 , ϵ 2 epsilon_1,epsilon_2 ϵ1,ϵ2,若满足
∣ ∣ θ ( i + 1 ) − θ ( i ) ∣ ∣ < ϵ 1 o r ∣ ∣ Q ( θ ( i + 1 ) , θ ( i ) ) − Q ( θ ( i ) , θ ( i ) ) ∣ ∣ < ϵ 2 ||theta^{(i + 1)} - theta^{(i)}|| < epsilon_1 space or spacespace ||Q(theta^{(i + 1)},theta^{(i)}) - Q(theta^{(i)},theta^{(i)}) ||< epsilon_2 ∣∣θ(i+1)−θ(i)∣∣<ϵ1 or ∣∣Q(θ(i+1),θ(i))−Q(θ(i),θ(i))∣∣<ϵ2
GMM模型形式与Adaboost算法很像,但是差别挺大的。说下异同点:
- 模型:都是加法模型,Adaboost基学习器不指定,也就是说明也可以使用高斯分布。
- 策略:Adaboost采用的是指数损失函数,而GMM采用的是对数损失函数,根据基学习函数和算法来选择较合适的就行,不是重要的区别项。
- 算法:Adaboost前向分步算法,基学习器数量M是根据终止循环条件确定的,基学习器权重系数 α m alpha_m αm之和不指定为1。GMM是采用EM算法,分模型数量K是在学习之前就指定的,分模型权重系数 α k alpha_k αk之和指定为1。Adaboost用于监督学习,GMM用于非监督学习,这是两种算法最主要的区别。
3.9 隐马尔科夫模型
详见隐马尔科夫模型。
3.9.1 模型
隐马尔科夫模型(hidden Markov model,HMM)是关于时序的概率模型,描述由一个隐藏的马尔科夫链随机生成不可观测的状态随机序列,再由各个状态生成一个观测而产生观测随机序列的过程。
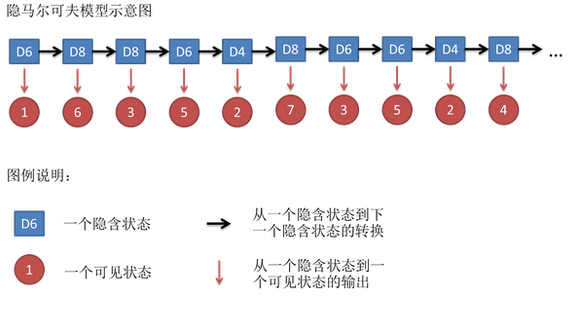
隐马尔科夫模型由初始状态概率向量
Π
Pi
Π、状态转移概率矩阵
A
A
A和观测概率矩阵
B
B
B决定。
Π
Pi
Π和
A
A
A决定状态序列,
B
B
B决定观测序列。因此,隐马尔科夫模型
λ
lambda
λ可以用三元符号表示,即
λ
=
(
A
,
B
,
Π
)
lambda = (A,B,Pi)
λ=(A,B,Π)
3.9.2 策略:极大似然估计,对数似然函数
完全数据的对数似然函数是 l n P ( O , I ∣ λ ) lnP(O,I|lambda) lnP(O,I∣λ)
3.9.3 算法:EM算法
EM算法的E步:极大化
Q
Q
Q函数
Q
(
λ
,
λ
ˉ
)
Q(lambda,barlambda)
Q(λ,λˉ)
a
r
g
  
max
λ
Q
(
λ
,
λ
ˉ
)
=
∑
I
P
(
I
∣
O
,
λ
ˉ
)
l
n
P
(
O
,
I
∣
λ
)
=
∑
I
P
(
O
,
I
∣
λ
ˉ
)
P
(
O
∣
λ
^
)
l
n
P
(
O
,
I
∣
λ
)
=
a
r
g
  
max
λ
∑
I
P
(
O
,
I
∣
λ
ˉ
)
l
n
P
(
O
,
I
∣
λ
)
begin{aligned}arg;max_{lambda} Q(lambda,barlambda) & = sum_{I}P(I|O,barlambda)lnP(O,I|lambda) = sum_{I}dfrac{P(O,I|barlambda)}{P(O|hatlambda)}lnP(O,I|lambda) \ & = arg;max_{lambda} sum_{I}P(O,I|barlambda)lnP(O,I|lambda) end{aligned}
argλmaxQ(λ,λˉ)=I∑P(I∣O,λˉ)lnP(O,I∣λ)=I∑P(O∣λ^)P(O,I∣λˉ)lnP(O,I∣λ)=argλmaxI∑P(O,I∣λˉ)lnP(O,I∣λ)
EM算法的M步:极大化 Q Q Q函数 Q ( λ , λ ˉ ) Q(lambda,barlambda) Q(λ,λˉ)求模型参数 A , B , Π A,B,Pi A,B,Π
3.9.4 预测:维特比算法
维特比算法实际是用动态规划解隐马尔科夫模型预测问题,即用动态规划求概率最大路径,这时一条路径对应着一个状态序列。
根据动态规划原理,最优路径具有这样的特性:如果最优路径在时刻t通过结点 i t ∗ i_t^* it∗,那么这一路经从结点 i t ∗ i_t^* it∗到终点 i T ∗ i_T^* iT∗的部分路径,对于从 i t ∗ i_t^* it∗到 i T ∗ i_T^* iT∗的所有可能的部分路径来说,必须是最优的。
3.10 线性链条件随机场
详见线性链条件随机场。
3.10.1 模型:时序数据上的对数线性模型
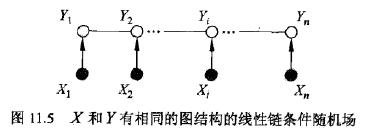
设有
K
1
K_1
K1个转移特征,
K
2
K_2
K2个状态特征,
K
=
K
1
+
K
2
K=K_1 + K_2
K=K1+K2,记
f
k
(
y
i
−
1
,
y
i
,
x
,
i
)
=
{
t
k
(
y
i
−
1
,
y
i
,
x
,
i
)
,
k
=
1
,
2
,
⋯
 
,
K
1
s
l
(
y
i
,
x
,
i
)
,
k
=
K
1
+
l
;
l
=
1
,
2
,
⋯
 
,
K
2
f_k(y_{i-1},y_i,x,i) = begin{cases} t_k(y_{i-1},y_i,x,i), & k=1,2,cdots,K_1 \[2ex] s_l(y_i,x,i), & k=K_1 + l;l=1,2,cdots,K_2 end{cases}
fk(yi−1,yi,x,i)=⎩⎨⎧tk(yi−1,yi,x,i),sl(yi,x,i),k=1,2,⋯,K1k=K1+l;l=1,2,⋯,K2
然后,对转移与状态特征在各个位置
i
 
i,
i求和,记作
f
k
(
y
,
x
)
=
∑
i
=
1
n
f
k
(
y
i
−
1
,
y
i
,
x
,
i
)
,
 
k
=
1
,
2
,
⋯
 
,
K
f_k(y,x) = sum_{i=1}^n f_k(y_{i-1},y_i,x,i),,k=1,2,cdots,K
fk(y,x)=i=1∑nfk(yi−1,yi,x,i),k=1,2,⋯,K
用
w
k
w_k
wk表示特征
f
k
(
y
,
x
)
f_k(y,x)
fk(y,x)的权值,即
w
k
=
{
λ
k
,
k
=
1
,
2
,
⋯
 
,
K
1
μ
l
,
k
=
K
1
+
l
;
l
=
1
,
2
,
⋯
 
,
K
2
w_k = begin{cases} lambda_k, & k=1,2,cdots,K_1 \[2ex] mu_l, & k=K_1 + l;l=1,2,cdots,K_2 end{cases}
wk=⎩⎨⎧λk,μl,k=1,2,⋯,K1k=K1+l;l=1,2,⋯,K2
于是,条件随机场可表示为
P ( y ∣ x ) = 1 Z ( x ) e x p ( ∑ k = 1 K w k f k ( y , x ) ) = 1 Z ( x ) e x p ( ∑ k = 1 K w k ∑ i = 1 n f k ( y i − 1 , y i , x , i ) ) = 1 Z ( x ) ∏ i e x p ( ∑ k = 1 K w k f k ( y i − 1 , y i , x , i ) ) P(y|x) = dfrac{1}{Z(x)}exp(sum_{k=1}^K w_k f_k(y,x)) = dfrac{1}{Z(x)}expleft(sum_{k=1}^K w_k sum_{i=1}^n f_k(y_{i-1},y_i,x,i)right) = dfrac{1}{Z(x)}prod_{i}expleft(sum_{k=1}^K w_k f_k(y_{i-1},y_i,x,i)right) P(y∣x)=Z(x)1exp(k=1∑Kwkfk(y,x))=Z(x)1exp(k=1∑Kwki=1∑nfk(yi−1,yi,x,i))=Z(x)1i∏exp(k=1∑Kwkfk(yi−1,yi,x,i))
Z ( x ) = ∑ y e x p ( ∑ k = 1 K w k f k ( y , x ) ) = ∑ y e x p ( ∑ k = 1 K w k ∑ i = 1 n f k ( y i − 1 , y i , x , i ) ) = ∑ y ∏ i e x p ( ∑ k = 1 K w k f k ( y i − 1 , y i , x , i ) ) Z(x) = sum_y exp(sum_{k=1}^K w_k f_k(y,x)) = sum_y expleft(sum_{k=1}^K w_k sum_{i=1}^n f_k(y_{i-1},y_i,x,i)right)= sum_y prod_{i}expleft(sum_{k=1}^K w_k f_k(y_{i-1},y_i,x,i)right) Z(x)=y∑exp(k=1∑Kwkfk(y,x))=y∑exp(k=1∑Kwki=1∑nfk(yi−1,yi,x,i))=y∑i∏exp(k=1∑Kwkfk(yi−1,yi,x,i))
3.10.2 策略:极大似然估计,对数似然函数
3.10.3 算法
- 通用迭代尺度法(GIS: Generalized Iterative Scaling)。
- 改进的迭代尺度法(IIS: Improved Iterative Scaling)。
- 梯度下降算法
- 拟牛顿法(牛顿法)
3.10.4 预测:维特比算法
四、十大统计学习方法知识点汇总
| 方法 | 适用问题 | 模型类型 | 模型 | 策略 | 损失函数 | 算法 |
|---|---|---|---|---|---|---|
| 感知机 | 二类分类 | 判别模型,非概率模型 | 分离超平面 | 极小化误分类点到超平面距离 | 误分类点到超平面距离 | 随机梯度下降 |
| k近邻法 | 多类分类,回归 | 判别模型,非概率模型 qquadqquad | 特征空间,样本点 | Nan | Nan | Nan |
| 朴素贝叶斯法 | 多类分类 | 生成模型,概率模型 | 特征与类别的联合概率分布,条件独立假设 | 极大似然估计,极大后验概率估计 | 对数似然损失 | 概率计算公式,EM算法 |
| 决策树 | 多分类,回归 | 判别模型,概率and非概率模型 | 分类树,回归树 | 正则化的极大似然估计 | 对数似然损失 | 特征选择,生成,剪枝 |
| 逻辑斯蒂回归与最大熵模型 | 多类分类 | 判别模型,概率and非概率模型 | 特征条件下类别的条件概率分布,对数线性模型 | 极大似然估计,正则化的极大似然估计 | 逻辑斯蒂损失 | 改进的迭代尺度算法,梯度下降,拟牛顿法 |
| 支持向量机 | 二类分类 | 判别模型,非概率模型 | 分离超平面,核技巧 | 极小化正则化合页损失,软间隔最大化 | 合页损失 | 序列最小最优化算法(SMO) |
| 提升方法 | 二类分类 | 判别模型,非概率模型 | 弱分类器的线性组合 | 极小化加法模型的指数损失 | 指数损失 | 前向分步加法算法 |
| EM算法 | 概率模型参数估计 | Nan   , | 含隐变量概率模型 | 极大似然估计,极大后验概率估计 | 对数似然损失 | 迭代算法 |
| 隐马尔科夫模型 | 标注 | 生成模型,概率模型 | 观测序列与状态序列的联合概率分布模型 | 极大似然估计,极大后验概率估计 | 对数似然损失 | 概率计算公式,EM算法 |
| 条件随机场 | 标注 | 判别模型,概率and非概率模型 | 状态序列条件下观测序列的条件概率分布,对数线性模型 | 极大似然估计,正则化极大似然估计 | 对数似然损失 | 改进的迭代尺度算法,梯度下降,拟牛顿法 |
参考资料:
- 李航 统计学习方法
最后
以上就是可靠柠檬最近收集整理的关于12_统计学习方法总结一、监督学习、分类方法、标注方法二、模型三、十大统计学习方法模型、策略与算法四、十大统计学习方法知识点汇总的全部内容,更多相关12_统计学习方法总结一、监督学习、分类方法、标注方法二、模型三、十大统计学习方法模型、策略与算法四、十大统计学习方法知识点汇总内容请搜索靠谱客的其他文章。
发表评论 取消回复