神经网络的正向传递与反向传播
- 1.单个神经元
- 2.由神经元组成的神经网络
- 3.目标函数
- 4.求解损失函数对某个权值的梯度
- 5.反向传播算法Backpropgation
- 5.1 明确一些定义
- 5.2 计算一个梯度
- 5.3 反向传播误差
- 6.优化示例
1.单个神经元
神经网络是由一系列神经元组成的模型,每一个神经元实际上做得事情就是实现非线性变换。
如下图就是一个神经元的结构:
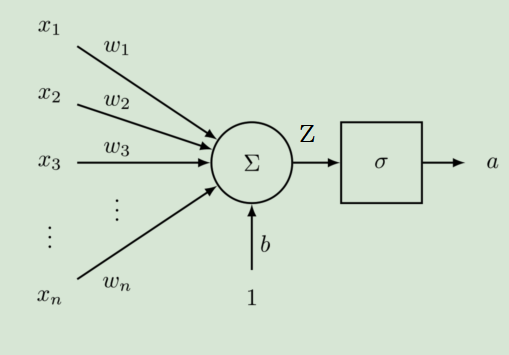
神经元将两个部分:上一层的输出 ( x 1 , x 2 . . . , x n ) (x_1,x_2...,x_n) (x1,x2...,xn)与权重 ( w 1 , w 2 . . . , w n ) (w_1,w_2...,w_n) (w1,w2...,wn) 对应相乘相加,然后再加上一个偏置 b b b 之后的值经过激活函数处理后完成非线性变换。
记
z
=
w
⋅
x
+
b
z=wcdot x+b
z=w⋅x+b,
a
=
σ
(
z
)
a=sigma(z)
a=σ(z),则
z
z
z 是神经元非线性变换之前的结果,这部分仅仅是一个简单的线性函数。
σ
sigma
σ是Sigmod激活函数,该函数可以将无穷区间内的数映射到(-1,1)的范围内。
a
a
a 是神经元将
z
z
z 进行非线性变换之后的结果。
Sigmod函数图像如下图:
s
i
g
m
o
d
(
x
)
=
1
1
+
e
−
x
sigmod(x)=frac{1}{1+e^{-x}}
sigmod(x)=1+e−x1
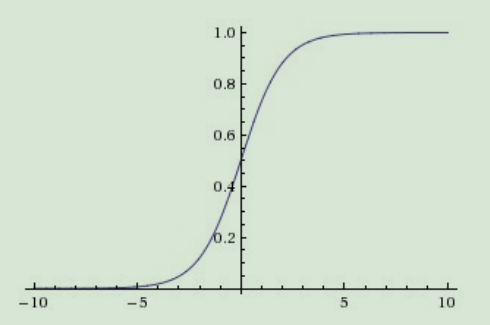
因此,结果
a
a
a 就等于:
a
=
1
1
+
e
−
(
w
1
x
1
+
w
2
x
2
+
.
.
.
+
w
n
x
n
+
b
)
a=frac{1}{1+e^{-(w_1x_1+w_2x_2+...+w_nx_n+b)}}
a=1+e−(w1x1+w2x2+...+wnxn+b)1
这里再强调一遍,神经元的本质就是做非线性变换。
2.由神经元组成的神经网络
神经元可以理解成一个函数,神经网络就是由很多个非线性变换的神经元组成的模型,因此神经网络可以理解成是一个非常复杂的复合函数。
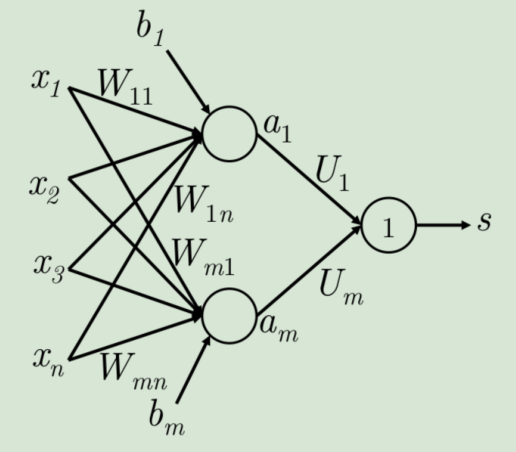
对于上图中的网络:
- ( x 1 , x 2 , . . . , x n ) (x_1,x_2,...,x_n) (x1,x2,...,xn) 为 n n n 维输入向量。
- W i j W_{ij} Wij,表示后一层第 i i i个神经元与前一层第 j j j个神经元之间的权值。
- z = W x + b z=Wx+b z=Wx+b,是没有经过激活函数非线性变换之前的结果。
- a = σ ( z ) a=σ(z) a=σ(z),是 z z z 经过激活函数非线性变换之后的结果。
- s = U T a s=U^T a s=UTa,为网络最终的输出结果。
3.目标函数
以折页损失为目标函数:
m
i
n
m
i
z
e
J
=
m
a
x
(
Δ
+
s
c
−
s
,
0
)
minmize J=max(Δ+s_c-s,0)
minmizeJ=max(Δ+sc−s,0)
其中 s c = U T σ ( W x c + b ) , s = U T σ ( W x + b ) s_c=U^Tσ(Wx_c+b),s=U^Tσ(Wx+b) sc=UTσ(Wxc+b),s=UTσ(Wx+b)。一般可以把 Δ 固定下来,比如设为1或者10。
一般来说,学习算法的学习过程就是优化调整参数,使得损失函数,或者说预测结果和实际结果的误差减小。BP算法其实是一个双向算法,包含两个步骤:
- 1.正向传递输入信息,得到 L o s s Loss Loss 值。
- 2.反向传播误差,从而由优化算法来调整网络权值。
4.求解损失函数对某个权值的梯度
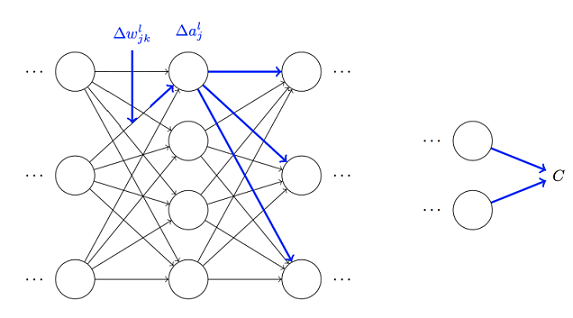
对于上面的图,假设图中指示出的网络中的某个权值 w j k l w^l_{jk} wjkl 发生了一个小的改变 Δ w j k l Δw^l_{jk} Δwjkl ,假设网络最终损失函数的输出为 C C C ,则 C C C 应该是关于 w j k l w^l_{jk} wjkl 的一个复合函数。
所谓复合函数,就是把 C C C 看成因变量,则 w j k l w^l_{jk} wjkl 可以看成是导致 C C C 改变的自变量,比如假设有一个复合函数 y = f ( g ( x ) ) y=f(g(x)) y=f(g(x)),则 y y y 就好比这里的 C C C , x x x 就好比 w j k l w^l_{jk} wjkl, w j k l w^l_{jk} wjkl 每经过一层网络可以看成是经过某个函数的处理 。而下面求导的时候都用偏导数,是因为虽然我们这里只关注了一个 w j k l w^l_{jk} wjkl,但是实际上网络中的每一个 w w w 都可以看成一个 x x x。
显然,这个 Δ w j k l Δw^l_{jk} Δwjkl 的变化会引起下一层直接与其相连的一个神经元,以及下一层之后所有神经元直到最终输出 C C C 的变化,如图中蓝线标记的就是该权值变化的影响传播路径。
把
C
C
C 的改变记为
Δ
C
ΔC
ΔC,则根据高等数学中导数的知识可以得到:
Δ
C
≈
∂
C
∂
w
j
k
l
Δ
w
j
k
l
(1)
ΔCapprox frac{partial C}{partial w^l_{jk}}Δw^l_{jk} tag1
ΔC≈∂wjkl∂CΔwjkl(1)
同样的道理可以得到上图中与
w
j
k
l
w^l_{jk}
wjkl 直接相连的神经元
a
j
l
a^l_j
ajl 发生的变化
Δ
a
j
l
Δa^l_j
Δajl :
Δ
a
j
l
≈
∂
a
j
l
∂
w
j
k
l
Δ
w
j
k
l
(2)
Δa^l_japprox frac{partial a^l_j}{partial w^l_{jk}}Δw^l_{jk}tag2
Δajl≈∂wjkl∂ajlΔwjkl(2)
则神经元
a
j
l
a^l_j
ajl 下面一层第
q
q
q 个与其相连的神经元
a
q
l
+
1
a^{l+1}_q
aql+1 的变化为:
Δ
a
q
l
+
1
≈
∂
a
q
l
+
1
∂
a
j
l
Δ
a
j
l
(3)
Δa^{l+1}_qapprox frac{partial a^{l+1}_q}{partial a^l_j}Δa^l_jtag3
Δaql+1≈∂ajl∂aql+1Δajl(3)
将
(
2
)
(2)
(2) 代入
(
3
)
(3)
(3) 可以得到:
Δ
a
q
l
+
1
≈
∂
a
q
l
+
1
∂
a
j
l
∂
a
j
l
∂
w
j
k
l
Δ
w
j
k
l
(4)
Δa^{l+1}_qapprox frac{partial a^{l+1}_q}{partial a^l_j} frac{partial a^l_j}{partial w^l_{jk}}Δw^l_{jk}tag4
Δaql+1≈∂ajl∂aql+1∂wjkl∂ajlΔwjkl(4)
假设从
a
j
l
a_j^l
ajl 到
C
C
C的一条路径为
a
j
l
,
a
q
l
+
1
,
.
.
.
,
a
n
L
−
1
,
a
m
L
a_j^l,a_q^{l+1},...,a_n^{L-1},a_m^{L}
ajl,aql+1,...,anL−1,amL,则在该条路径上
C
C
C 的变化量
Δ
C
ΔC
ΔC 为:
Δ
C
≈
∂
C
∂
a
m
L
∂
a
m
L
∂
a
n
L
−
1
∂
a
n
L
−
1
∂
a
p
L
−
2
.
.
.
∂
a
q
l
+
1
∂
a
j
l
∂
a
j
l
∂
w
j
k
l
Δ
w
j
k
l
(5)
ΔCapprox frac{partial C}{partial a^L_m} frac{partial a^L_m}{partial a^{L-1}_n} frac{partial a^{L-1}_n}{partial a^{L-2}_p}...frac{partial a^{l+1}_q}{partial a^l_j} frac{partial a^l_j}{partial w^l_{jk}}Δw^l_{jk}tag5
ΔC≈∂amL∂C∂anL−1∂amL∂apL−2∂anL−1...∂ajl∂aql+1∂wjkl∂ajlΔwjkl(5)
至此,我们已经得到了一条路径上的变化量,其实本质就是链式求导法则,或者说是复合函数求导法则。那么整个的变化量就是把所有可能链路上的变化量加起来:
Δ
C
≈
∑
m
n
p
.
.
.
q
∂
C
∂
a
m
L
∂
a
m
L
∂
a
n
L
−
1
∂
a
n
L
−
1
∂
a
p
L
−
2
.
.
.
∂
a
q
l
+
1
∂
a
j
l
∂
a
j
l
∂
w
j
k
l
Δ
w
j
k
l
(6)
ΔCapprox sum_{mnp...q} frac{partial C}{partial a^L_m} frac{partial a^L_m}{partial a^{L-1}_n} frac{partial a^{L-1}_n}{partial a^{L-2}_p}...frac{partial a^{l+1}_q}{partial a^l_j} frac{partial a^l_j}{partial w^l_{jk}}Δw^l_{jk}tag6
ΔC≈mnp...q∑∂amL∂C∂anL−1∂amL∂apL−2∂anL−1...∂ajl∂aql+1∂wjkl∂ajlΔwjkl(6)
则
C
C
C 对某个权值
w
j
k
l
w^l_{jk}
wjkl 的梯度为:
∂
C
∂
w
j
k
l
≈
∑
m
n
p
.
.
.
q
∂
C
∂
a
m
L
∂
a
m
L
∂
a
n
L
−
1
∂
a
n
L
−
1
∂
a
p
L
−
2
.
.
.
∂
a
q
l
+
1
∂
a
j
l
∂
a
j
l
∂
w
j
k
l
(7)
frac{partial C}{partial w^l_{jk}}approx sum_{mnp...q} frac{partial C}{partial a^L_m} frac{partial a^L_m}{partial a^{L-1}_n} frac{partial a^{L-1}_n}{partial a^{L-2}_p}...frac{partial a^{l+1}_q}{partial a^l_j} frac{partial a^l_j}{partial w^l_{jk}}tag7
∂wjkl∂C≈mnp...q∑∂amL∂C∂anL−1∂amL∂apL−2∂anL−1...∂ajl∂aql+1∂wjkl∂ajl(7)
到这里从数学分析的角度来说,我们可以知道这个梯度是可以计算和求解的。
总结:
- 1.每两个神经元之间是由一条边连接的,这个边就是一个权重值,它是后一个神经元 z z z部分,也就是未经激活函数非线性变换之前的结果对前一个神经元的 a a a部分,也就是经激活函数非线性变换之后的结果的偏导数。
- 2.一条链路上所有偏导数的乘积就是这条路径的变化量。
- 3.所有路径变化量之和就是整个损失函数的变化量。
5.反向传播算法Backpropgation
5.1 明确一些定义
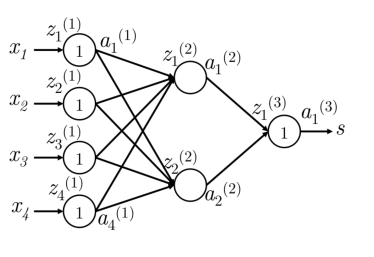
对于上面的神经网络,首先明确下面一些定义:
- x i x_i xi是网络的输入。
- s s s是网络的输出。
- z j ( k ) z^{(k)}_j zj(k) 表示第 k k k 层第 j j j 个神经元在激活函数非线性变换之前的结果。
- a j ( k ) a^{(k)}_j aj(k) 表示第 k k k 层第 j j j 个神经元在激活函数非线性变换之后的结果,也就是说 a j ( k ) = σ ( z j ( k ) ) a^{(k)}_j=σ(z^{(k)}_j) aj(k)=σ(zj(k))。
- 对于输入层: x j = z j ( 1 ) = a j ( 1 ) x_j=z_j^{(1)}=a_j^{(1)} xj=zj(1)=aj(1)。
- W i j ( l ) W_{ij}^{(l)} Wij(l),表示 l + 1 l+1 l+1 层第 i i i个神经元与前一层第 j j j个神经元之间的权值。
一个特别重要的定义:
- δ j ( k ) δ^{(k)}_j δj(k)是一个定义,这个定义指的是损失函数在 z j ( k ) z^{(k)}_j zj(k)处的反向传播误差,即损失函数对 z j ( k ) z^{(k)}_j zj(k)的梯度: δ j ( k ) = ∂ J ∂ z j ( k ) δ^{(k)}_j=frac{partial J}{partial z^{(k)}_j} δj(k)=∂zj(k)∂J, J J J 为损失函数。这个定义在后面推导反向传播的时候会用到,每一处的 δ j ( k ) δ^{(k)}_j δj(k)都是通过后面的 δ δ δ 传递整合得到的,后面会具体分析整过程,这样的过程可以大大简化计算。
5.2 计算一个梯度
假设损失函数为: J = ( 1 + s c − s ) J = (1+s_c-s) J=(1+sc−s)。
来计算一下 ∂ J ∂ W 14 ( 1 ) frac{partial J}{partial W_{14}^{(1)}} ∂W14(1)∂J,由于 s s s 是网络的输出, ∂ J ∂ s = − 1 frac{partial J}{partial s}=-1 ∂s∂J=−1,所以只需要计算 ∂ s ∂ W 14 ( 1 ) frac{partial s}{partial W_{14}^{(1)}} ∂W14(1)∂s即可。
而由于
s
s
s 激活函数就是1,所以有:
s
=
a
1
(
3
)
=
z
1
(
3
)
=
W
11
(
2
)
a
1
(
2
)
+
W
12
(
2
)
a
2
(
2
)
(8)
s=a_1^{(3)}=z_1^{(3)}=W^{(2)}_{11}a^{(2)}_1+W^{(2)}_{12}a^{(2)}_2tag8
s=a1(3)=z1(3)=W11(2)a1(2)+W12(2)a2(2)(8)
∂ s ∂ W 14 ( 1 ) = ∂ ( W 11 ( 2 ) a 1 ( 2 ) + W 12 ( 2 ) a 2 ( 2 ) ) ∂ W 14 ( 1 ) (9) frac{partial s}{partial W_{14}^{(1)}}=frac{partial (W^{(2)}_{11}a^{(2)}_1+W^{(2)}_{12}a^{(2)}_2)}{partial W_{14}^{(1)}}tag9 ∂W14(1)∂s=∂W14(1)∂(W11(2)a1(2)+W12(2)a2(2))(9)
显然 W 14 ( 1 ) W_{14}^{(1)} W14(1) 只会影响 z 1 ( 2 ) z^{(2)}_1 z1(2) 和 a 1 ( 2 ) a^{(2)}_1 a1(2),所以 W 12 ( 2 ) a 2 ( 2 ) W^{(2)}_{12}a^{(2)}_2 W12(2)a2(2)对 W 14 ( 1 ) W_{14}^{(1)} W14(1) 求偏导就是0,并且上面的网络可以简化成下面的图:
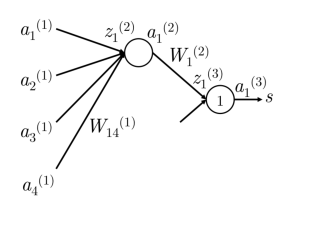
所以:
∂
s
∂
W
14
(
1
)
=
∂
W
11
(
2
)
a
1
(
2
)
∂
W
14
(
1
)
=
W
11
(
2
)
∂
a
1
(
2
)
∂
W
14
(
1
)
(9)
frac{partial s}{partial W_{14}^{(1)}}=frac{partial W^{(2)}_{11}a^{(2)}_1}{partial W_{14}^{(1)}}=W^{(2)}_{11}frac{partial a^{(2)}_1}{partial W_{14}^{(1)}}tag9
∂W14(1)∂s=∂W14(1)∂W11(2)a1(2)=W11(2)∂W14(1)∂a1(2)(9)
由于
a
1
(
2
)
=
σ
(
z
1
(
2
)
)
a^{(2)}_1 = σ(z^{(2)}_1)
a1(2)=σ(z1(2)),
z
1
(
2
)
=
b
1
(
1
)
+
∑
k
a
k
(
1
)
W
1
k
(
1
)
z^{(2)}_1=b_1^{(1)}+sum_ka_k^{(1)}W_{1k}^{(1)}
z1(2)=b1(1)+∑kak(1)W1k(1),
∂
a
1
(
2
)
∂
z
1
(
2
)
=
σ
′
(
z
1
(
2
)
)
frac{partial a^{(2)}_1}{partial z^{(2)}_1}=σ^{prime}(z^{(2)}_1)
∂z1(2)∂a1(2)=σ′(z1(2)),代入公式
(
9
)
(9)
(9) 可以得到:
∂
s
∂
W
14
(
1
)
=
W
11
(
2
)
∂
a
1
(
2
)
∂
W
14
(
1
)
=
W
11
(
2
)
∂
a
1
(
2
)
∂
z
1
(
2
)
∂
z
1
(
2
)
∂
W
14
(
1
)
1
=
W
11
(
2
)
σ
′
(
z
1
(
2
)
)
∂
(
b
1
(
1
)
+
∑
k
a
k
(
1
)
W
1
k
(
1
)
)
∂
W
14
(
1
)
(10)
frac{partial s}{partial W_{14}^{(1)}}= W^{(2)}_{11}frac{partial a^{(2)}_1}{partial W_{14}^{(1)}}= W^{(2)}_{11}frac{partial a^{(2)}_1}{partial z^{(2)}_1}frac{partial z^{(2)}_1}{partial W_{14}^{(1)}1}\= W^{(2)}_{11}σ^{prime}(z^{(2)}_1)frac{partial (b_1^{(1)}+sum_ka_k^{(1)}W_{1k}^{(1)})}{partial W_{14}^{(1)}tag{10}}
∂W14(1)∂s=W11(2)∂W14(1)∂a1(2)=W11(2)∂z1(2)∂a1(2)∂W14(1)1∂z1(2)=W11(2)σ′(z1(2))∂W14(1)∂(b1(1)+∑kak(1)W1k(1))(10)
公式 ( 10 ) (10) (10) 中 ∂ ( b 1 ( 1 ) + ∑ k a k ( 1 ) W 1 k ( 1 ) ) ∂ W 14 ( 1 ) = a 4 ( 1 ) frac{partial (b_1^{(1)}+sum_ka_k^{(1)}W_{1k}^{(1)})}{partial W_{14}^{(1)}}=a_4^{(1)} ∂W14(1)∂(b1(1)+∑kak(1)W1k(1))=a4(1) 。
此外还有一个更重要的变换,同样的方法可以求出:
∂
J
∂
z
1
(
2
)
=
W
11
(
2
)
σ
′
(
z
1
(
2
)
)
frac{partial J}{partial z^{(2)}_1}=W^{(2)}_{11}σ^{prime}(z^{(2)}_1)
∂z1(2)∂J=W11(2)σ′(z1(2))
并且结合前面对
δ
j
(
k
)
δ^{(k)}_j
δj(k) 的定义,公式
(
10
)
(10)
(10) 可以写成:
∂
s
∂
W
14
(
1
)
=
∂
J
∂
z
1
(
2
)
a
4
(
1
)
=
δ
1
(
2
)
a
4
(
1
)
(11)
frac{partial s}{partial W_{14}^{(1)}} =frac{partial J}{partial z^{(2)}_1}a_4^{(1)}=δ^{(2)}_1a_4^{(1)}tag{11}
∂W14(1)∂s=∂z1(2)∂Ja4(1)=δ1(2)a4(1)(11)
所以损失函数对任意一个网络权值的梯度可以写成两个值相乘的形式。对于 a 4 ( 1 ) a_4^{(1)} a4(1),它是网络前向传递过程中的一个神经元的输出,我们当然可以在网络前向传递的时候将它保存下来。而对于 δ 1 ( 2 ) δ^{(2)}_1 δ1(2),它是反向传播过来的梯度,也就是 J J J 对 z z z 的梯度,下面来看如何通过后面神经元的 δ i ( k ) δ^{(k)}_i δi(k) 反向传播得到 前一个神经元处的 δ j ( k − 1 ) δ^{(k-1)}_j δj(k−1) 。
5.3 反向传播误差
到这里需要注意,反向传播仅指用于计算梯度的方法,它并不是用于神经网络的整个学习算法。通过反向传播算法算法得到梯度之后,可以使用比如随机梯度下降算法等来进行学习。
反向传播算法传播的是误差,传播方向是从最后一层依次往前,这是一个迭代的过程。在上面的过程中,我们求得了损失函数对于某个权值的梯度,通过该处的梯度值,可以将其向前传播,得到前一个结点的梯度。
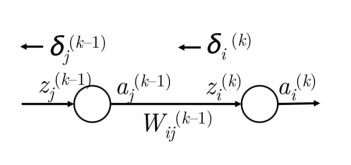
例如对于上面的图,假设已经求出
z
i
(
k
)
z^{(k)}_i
zi(k) 处的梯度
δ
i
(
k
)
δ^{(k)}_i
δi(k),则将误差按照某条连接路径,传递到
a
j
(
k
−
1
)
a^{(k-1)}_j
aj(k−1)处,则该处的梯度为
δ
i
(
k
)
W
i
j
(
k
−
1
)
δ^{(k)}_iW^{(k-1)}_{ij}
δi(k)Wij(k−1)。
实际上这只是一条路径,
a
j
(
k
−
1
)
a^{(k-1)}_j
aj(k−1)处可能会收到很多个不同的误差,例如下面该神经元后面有两条权值边的情况:
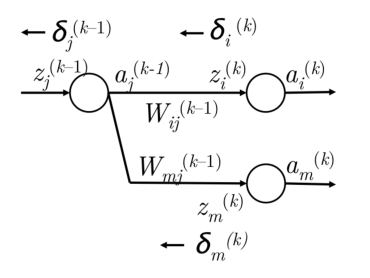
这个时候只要把它们相加就好了,所以 a j ( k − 1 ) a^{(k-1)}_j aj(k−1)处,则该处的梯度为 ∑ i δ i ( k ) W i j ( k − 1 ) sum_iδ^{(k)}_iW^{(k-1)}_{ij} ∑iδi(k)Wij(k−1)。
于是 z j ( k − 1 ) z^{(k-1)}_j zj(k−1) 处的梯度 δ j ( k − 1 ) δ^{(k-1)}_j δj(k−1) 就为 σ ′ ( z j ( k − 1 ) ) ∑ i δ i ( k ) W i j ( k − 1 ) σ^{prime}(z^{(k-1)}_j)sum_iδ^{(k)}_iW^{(k-1)}_{ij} σ′(zj(k−1))∑iδi(k)Wij(k−1)。
所以只要从网络的最后面开始,迭代上面的过程,就可以求出网络每个地方 J J J 对 z z z 梯度,从而求出 J J J 对与 z z z相连的 w w w 的梯度了。
6.优化示例
再次说一下,反向传播仅指用于计算梯度的方法,它并不是用于神经网络的整个学习算法。通过反向传播算法算法得到梯度之后,还需要使用比如随机梯度下降算法等来进行学习。
在上面的过程中,我们通过反向传播算法求解出了任意一个
z
j
(
i
)
z^{(i)}_j
zj(i) 处的梯度
δ
j
(
i
)
δ^{(i)}_j
δj(i) ,为什么是
z
j
(
i
)
z^{(i)}_j
zj(i) 而不是
a
j
(
i
)
a^{(i)}_j
aj(i)呢,因为
z
j
(
i
)
z^{(i)}_j
zj(i)前面就是连接它的
w
w
w,以随机梯度下降算法为例,
w
w
w的优化方法为:
w
i
j
n
e
w
(
l
)
=
w
i
j
o
l
d
(
l
)
−
η
⋅
∂
J
∂
w
i
j
(
l
)
=
w
i
j
o
l
d
(
l
)
−
η
⋅
δ
i
(
l
+
1
)
⋅
a
j
(
l
)
(12)
w_{ijnew}^{(l)}=w_{ijold}^{(l)}-η·frac{partial J}{partial w_{ij}^{(l)}}=w_{ijold}^{(l)}-η·δ^{(l+1)}_i·a_j^{(l)}tag{12}
wijnew(l)=wijold(l)−η⋅∂wij(l)∂J=wijold(l)−η⋅δi(l+1)⋅aj(l)(12)
最后
以上就是难过帅哥最近收集整理的关于神经网络的正向传递与反向传播的全部内容,更多相关神经网络内容请搜索靠谱客的其他文章。
发表评论 取消回复