策略搜索方法相对于值函数法有如下优缺点
优点:
- 直接策略搜索方法是对策略 π pi π进行参数化表示,与值函数方中对值函数进行参数化表示相比,策略参数化更简单,有更好的收敛性。
- 利用值函数方法求解最优策略时,策略改进需要求解 a r g m a x a Q θ ( s , a ) argmax_a Q_theta(s,a) argmaxaQθ(s,a),当要解决的问题动作空间很大或者动作为连续集时,该式无法有效求解。
- 直接策略搜索方法经常采用的随机策略,能够学习随机策略。可以将探索直接集成到策略之中。
缺点:
- 策略搜索的方法容易收敛到局部最小值。
- 评估单个策略时并不充分,方差较大。
一、基础算法推导
本文主要从重要性采样角度进行分析。
策略梯度的目标依旧是最大化累积回报,定义一个参数化策略
π
θ
pi_theta
πθ的期望累积回报如下所示
J
(
θ
)
=
E
τ
∼
p
(
τ
;
θ
)
=
∫
τ
∼
p
(
τ
;
θ
)
p
(
τ
;
θ
)
r
(
τ
)
d
τ
begin{aligned} J(theta) = E_{tau sim p(tau;theta)}&=int_{tausim p(tau;theta)}p(tau;theta)r(tau)dtau\ end{aligned}
J(θ)=Eτ∼p(τ;θ)=∫τ∼p(τ;θ)p(τ;θ)r(τ)dτ
p
(
τ
;
θ
)
p(tau;theta)
p(τ;θ)表示在策略
π
θ
pi_theta
πθ的情况下轨迹
τ
tau
τ出现的概率,在计算时无法通过一个不确定参数的分布
p
(
τ
;
θ
)
p(tau;theta)
p(τ;θ)进行采样,因此通过重要性采样的方式,推导如下所示。
J
(
θ
)
=
∫
τ
p
(
τ
;
θ
o
l
d
)
p
(
τ
;
θ
o
l
d
)
p
(
τ
;
θ
)
r
(
τ
)
d
τ
=
∫
τ
p
(
τ
;
θ
o
l
d
)
p
(
τ
;
θ
)
p
(
τ
;
θ
o
l
d
)
r
(
τ
)
d
τ
=
E
τ
∼
p
(
τ
;
θ
o
l
d
)
[
p
(
τ
;
θ
)
p
(
τ
;
θ
o
l
d
)
r
(
τ
)
]
begin{aligned} J(theta)&=int_{tau}frac{p(tau;theta_{old})}{p(tau;theta_{old})}p(tau;theta)r(tau)dtau\ &=int_{tau}p(tau;theta_{old})frac{p(tau;theta)}{p(tau;theta_{old})}r(tau)dtau\ &=E_{tausim p(tau;theta_{old})}[frac{p(tau;theta)}{p(tau;theta_{old})}r(tau)] end{aligned}
J(θ)=∫τp(τ;θold)p(τ;θold)p(τ;θ)r(τ)dτ=∫τp(τ;θold)p(τ;θold)p(τ;θ)r(τ)dτ=Eτ∼p(τ;θold)[p(τ;θold)p(τ;θ)r(τ)]
对上述公式求导,由于策略函数通常是连续可微的良好函数,因此求导和积分符号可以互换。
∇
θ
J
(
θ
)
=
∫
τ
∇
θ
p
(
τ
;
θ
)
r
(
τ
)
d
τ
=
∫
τ
p
(
τ
;
θ
)
p
(
τ
;
θ
)
∇
θ
p
(
τ
;
θ
)
r
(
τ
)
d
τ
=
∫
τ
p
(
τ
;
θ
)
∇
θ
log
p
(
τ
;
θ
)
r
(
τ
)
d
τ
=
E
τ
∼
p
(
τ
;
θ
)
[
∇
θ
log
p
(
τ
;
θ
)
r
(
τ
)
]
begin{aligned} nabla_{theta}J(theta)&=int_{tau}nabla_{theta}p(tau;theta)r(tau)dtau\ &=int_{tau}frac{p(tau;theta)}{p(tau;theta)}nabla_{theta}p(tau;theta)r(tau)dtau\ &=int_{tau}p(tau;theta)nabla_{theta}log{p(tau;theta)}r(tau)dtau\ &=E_{tausim p(tau;theta)}[nabla_{theta}log{p(tau;theta)}r(tau)] end{aligned}
∇θJ(θ)=∫τ∇θp(τ;θ)r(τ)dτ=∫τp(τ;θ)p(τ;θ)∇θp(τ;θ)r(τ)dτ=∫τp(τ;θ)∇θlogp(τ;θ)r(τ)dτ=Eτ∼p(τ;θ)[∇θlogp(τ;θ)r(τ)]
上述公式中的
p
(
τ
;
θ
)
p(tau;theta)
p(τ;θ)是一个不易计算的部分,化简过程如下
p
(
τ
;
θ
)
=
p
(
s
0
)
∏
t
=
0
T
π
θ
(
a
t
∣
s
t
)
p
(
s
t
+
1
∣
s
t
)
p(tau;theta) = p(s_0)prod_{t=0}^Tpi_theta(a_t|s_t)p(s_{t+1}|s_t)
p(τ;θ)=p(s0)t=0∏Tπθ(at∣st)p(st+1∣st)
对上述公式求导得
∇
θ
log
p
(
τ
;
θ
)
=
∇
θ
[
log
p
(
s
0
)
+
∑
t
=
0
T
log
π
θ
(
a
t
∣
s
t
)
+
∑
t
=
0
T
p
(
s
t
+
1
∣
s
t
)
]
=
∇
θ
log
π
θ
(
a
t
∣
s
t
)
begin{aligned} nabla_{theta}log p(tau;theta)&= nabla_{theta}[log p(s_0) + sum_{t=0}^Tlog pi_theta(a_t|s_t)+sum_{t=0}^T p(s_{t+1}|s_{t})]\ &=nabla_{theta}log pi_{theta}(a_t|s_t) end{aligned}
∇θlogp(τ;θ)=∇θ[logp(s0)+t=0∑Tlogπθ(at∣st)+t=0∑Tp(st+1∣st)]=∇θlogπθ(at∣st)
由于状态之间的转移概率与模型的动力学有关,与参数
θ
theta
θ无关,所以在求导时消掉。此后我们可以采用蒙特卡洛近似方法进行梯度的近似求解
∇
θ
J
(
θ
)
=
1
N
∑
i
=
1
N
∇
θ
log
π
θ
(
τ
t
,
θ
)
r
(
τ
i
)
=
1
N
∑
i
=
1
N
[
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
(
∑
t
=
0
T
r
(
s
i
,
t
,
a
i
,
t
)
)
]
begin{aligned} nabla_{theta}J(theta) &= frac{1}{N}sum_{i=1}^Nnabla_{theta}log pi_theta(tau_t,theta)r(tau_i)\ &=frac{1}{N}sum_{i=1}^N[(sum_{t=0}^Tnabla_{theta}log pi_theta(a_{i,t}|s_{i,t}))(sum_{t=0}^Tr(s_{i,t},a_{i,t}))] end{aligned}
∇θJ(θ)=N1i=1∑N∇θlogπθ(τt,θ)r(τi)=N1i=1∑N[(t=0∑T∇θlogπθ(ai,t∣si,t))(t=0∑Tr(si,t,ai,t))]
下面具体介绍一下梯度公式的物理意义,如上所示
∇
θ
log
π
θ
(
τ
t
,
θ
)
nabla_{theta}log pi_theta(tau_t,theta)
∇θlogπθ(τt,θ)是轨迹
τ
tau
τ的概率随参数
θ
theta
θ变化最陡的方向。参数在该方向上更新时,若沿着正方向,则该轨迹出现的概率增大,若沿着负方向,则该轨迹出现的概率减小。
r
(
τ
)
r(tau)
r(τ)表示这条轨迹的累积奖励,若这条轨迹能够获得正向回报,则该轨迹概率增加,回报越多概率增加越大;若这条轨迹获得负回报,则该轨迹概率降低。则参数更新为
θ
t
+
1
=
θ
t
+
α
∇
θ
J
(
θ
)
∣
θ
=
θ
t
theta_{t+1} = theta_{t} + alpha nabla_{theta}J(theta)|_{theta= theta_{t}}
θt+1=θt+α∇θJ(θ)∣θ=θt
下面介绍常见的随机策略方法,随机策略通常写为一个确定性策略部分加随机策略部分
π
θ
=
μ
θ
+
ε
pi_theta=mu_theta + varepsilon
πθ=μθ+ε
其中确定性策略可以写为径向基策略,神经网络策略,如下使用线性策略作为确定性策略,随机策略使用高斯策略
μ
θ
(
s
)
=
ϕ
(
s
)
T
θ
ε
∼
N
(
0
,
σ
2
)
begin{aligned} mu_theta(s)=phi(s)^Ttheta\ varepsilonsim N(0,sigma^2) end{aligned}
μθ(s)=ϕ(s)Tθε∼N(0,σ2)
则随机策略可以写为
π
θ
(
a
∣
s
)
=
1
2
π
σ
exp
(
−
(
a
−
ϕ
(
s
)
T
θ
)
2
2
σ
2
)
pi_theta(a|s)=frac{1}{sqrt{2pi}sigma}exp(-frac{(a-phi(s)^Ttheta)^2}{2sigma^2})
πθ(a∣s)=2πσ1exp(−2σ2(a−ϕ(s)Tθ)2)
通常也可以直接让神经网络产出
N
∼
(
μ
,
σ
2
)
Nsim(mu,sigma^2)
N∼(μ,σ2)中的两个参数。
如上就是基本的策略梯度算法推导。下面介绍算法的改进与实现方式。
二、算法改进
根据原始策略公式如下
∇
θ
J
(
θ
)
=
1
N
∑
i
=
1
N
[
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
(
∑
t
=
0
T
r
(
s
i
,
t
,
a
i
,
t
)
)
]
nabla_{theta}J(theta)=frac{1}{N}sum_{i=1}^N[(sum_{t=0}^Tnabla_{theta}log pi_theta(a_{i,t}|s_{i,t}))(sum_{t=0}^Tr(s_{i,t},a_{i,t}))]
∇θJ(θ)=N1i=1∑N[(t=0∑T∇θlogπθ(ai,t∣si,t))(t=0∑Tr(si,t,ai,t))]
- 优化一
上式有一个问题,不论哪个时刻,策略的梯度都需要乘上所有时刻的回报值总和。但是该时刻t的动作对之前时刻的回报没有任何影响,不应该乘在梯度中。做如下简化
∇
θ
J
(
θ
)
=
1
N
∑
i
=
1
N
[
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
(
∑
t
′
=
t
T
r
(
s
i
,
t
′
,
a
i
,
t
′
)
)
]
nabla_{theta}J(theta)=frac{1}{N}sum_{i=1}^N[(sum_{t=0}^Tnabla_{theta}log pi_theta(a_{i,t}|s_{i,t}))(sum_{t'=t}^Tr(s_{i,t'},a_{i,t'}))]
∇θJ(θ)=N1i=1∑N[(t=0∑T∇θlogπθ(ai,t∣si,t))(t′=t∑Tr(si,t′,ai,t′))]
2. 优化二
上式还有还有三个问题。1.如果权重(累积回报值)较大,那么参数的更新量会变大,这样模型的波动较大,可能影响最终的模型效果。2.在一些强化学习中,环境给与的回报可能一直为正值,那么所有的轨迹的概率都会或多或少的增加,这显然不符合我们的优化目标。我们应当让累积回报大的轨迹概率增加,累积回报小的轨迹概率减小。3.策略采用蒙特卡洛方法,虽然是求期望的无偏估计,但是过分依赖每一次采样轨迹,方差十分大,我们可以引入基线baseline来减小方差。
∇
θ
J
(
θ
)
=
1
N
∑
i
=
1
N
[
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
(
∑
t
′
=
t
T
r
(
s
i
,
t
′
,
a
i
,
t
′
)
−
b
)
]
nabla_{theta}J(theta)=frac{1}{N}sum_{i=1}^N[(sum_{t=0}^Tnabla_{theta}log pi_theta(a_{i,t}|s_{i,t}))(sum_{t'=t}^Tr(s_{i,t'},a_{i,t'})-b)]
∇θJ(θ)=N1i=1∑N[(t=0∑T∇θlogπθ(ai,t∣si,t))(t′=t∑Tr(si,t′,ai,t′)−b)]
现证明加入一个常数项
b
i
,
t
b_{i,t}
bi,t不会使原本的估计变得有偏,假设策略估计函数是一个定义良好的函数,求导与积分可以互换。
E
τ
∼
p
(
τ
;
θ
)
[
∇
θ
log
p
(
τ
;
θ
)
b
]
=
∫
τ
p
(
τ
;
θ
)
∇
θ
log
p
(
τ
;
θ
)
b
d
τ
=
∫
τ
p
(
τ
;
θ
)
∇
θ
p
(
τ
;
θ
)
p
(
τ
;
θ
)
b
d
τ
=
b
∫
τ
∇
θ
p
(
τ
;
θ
)
d
τ
=
b
∇
θ
∫
τ
p
(
τ
;
θ
)
d
τ
=
b
∇
θ
1
=
0
begin{aligned} E_{tausim p(tau;theta)}[nabla_{theta}log p(tau;theta)b]&=int_{tau}p(tau;theta)nabla_{theta}log p(tau;theta)b~ dtau\ &=int_{tau}p(tau;theta)frac{nabla_theta p(tau;theta)}{p(tau;theta)}b ~ dtau\ &=bint_{tau}nabla_{theta} p(tau;theta) dtau\ &=bnabla_thetaint_{tau}p(tau;theta)dtau\ &=bnabla_{theta}1\ &=0 end{aligned}
Eτ∼p(τ;θ)[∇θlogp(τ;θ)b]=∫τp(τ;θ)∇θlogp(τ;θ)b dτ=∫τp(τ;θ)p(τ;θ)∇θp(τ;θ)b dτ=b∫τ∇θp(τ;θ)dτ=b∇θ∫τp(τ;θ)dτ=b∇θ1=0
因此引入基线
b
b
b不会给梯度估计引入偏差。基线处于减小方差的目标,其选取公式推导如下,令随机变量为
X
=
∑
t
=
0
T
[
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
(
∑
t
′
=
t
T
r
(
s
i
,
t
,
a
i
,
t
)
−
b
)
]
X = sum_{t=0}^T[nabla_{theta}log pi_{theta}(a_{i,t}|s_{i,t})(sum_{t'=t}^Tr(s_{i,t},a_{i,t})-b)]
X=t=0∑T[∇θlogπθ(ai,t∣si,t)(t′=t∑Tr(si,t,ai,t)−b)]
计算方差为
V
a
r
(
X
)
=
E
[
X
−
X
‾
]
2
=
E
[
X
2
]
−
(
E
[
X
‾
]
)
2
begin{aligned} Var(X)&=E[X-overline X]^2\ &=E[X^2]-(E[overline X])^2 end{aligned}
Var(X)=E[X−X]2=E[X2]−(E[X])2
为了求方差的极小值点,则为梯度为0处
∂
V
a
r
(
X
)
∂
b
=
E
[
X
∂
X
∂
b
]
=
0
begin{aligned} frac{partial Var(X)}{partial b}&=E[Xfrac{partial X}{partial b}]=0\ end{aligned}
∂b∂Var(X)=E[X∂b∂X]=0
可得
b
=
∑
i
=
1
N
[
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
∑
t
′
=
t
T
r
(
s
i
,
t
′
,
a
i
,
t
′
)
)
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
]
∑
i
=
1
N
(
∑
t
=
0
T
∇
θ
log
π
θ
(
a
i
,
t
∣
s
i
,
t
)
)
2
b = frac{sum_{i=1}^N[(sum_{t=0}^Tnabla_{theta}log pi_{theta}(a_{i,t}|s_{i,t})sum_{t'=t}^Tr(s_{i,t'},a_{i,t'}))(sum_{t=0}^Tnabla_{theta}log pi_{theta}(a_{i,t}|s_{i,t}))]}{sum_{i=1}^N(sum_{t=0}^Tnabla_{theta}log pi_{theta}(a_{i,t}|s_{i,t}))^2}
b=∑i=1N(∑t=0T∇θlogπθ(ai,t∣si,t))2∑i=1N[(∑t=0T∇θlogπθ(ai,t∣si,t)∑t′=tTr(si,t′,ai,t′))(∑t=0T∇θlogπθ(ai,t∣si,t))]
三、算法实现
我们现在拿到了随机策略梯度公式
∇
θ
J
(
θ
)
=
E
s
∼
ρ
π
θ
,
a
∼
π
θ
[
∇
θ
log
π
(
a
∣
s
)
(
Q
(
s
,
a
)
−
b
)
]
begin{aligned} nabla_{theta}J(theta)=E_{ssim rho_{pi_theta},asim pi_theta}[nabla_{theta}log pi(a|s)(Q(s,a)-b)]\ end{aligned}
∇θJ(θ)=Es∼ρπθ,a∼πθ[∇θlogπ(a∣s)(Q(s,a)−b)]
为了方便实现,根据上述梯度公式,我们可以将策略梯度的损失函数写为
L
=
−
E
s
∼
ρ
π
θ
o
l
d
,
a
∼
π
θ
o
l
d
[
log
π
θ
(
a
∣
s
)
(
Q
(
s
,
a
)
−
b
)
]
=
−
∬
π
θ
o
l
d
log
π
θ
(
a
∣
s
)
(
Q
(
s
,
a
)
−
b
)
d
s
d
a
begin{aligned} L&=-E_{ssim rho_{pi_{theta_{old}},asim pi_{theta_{old}}}}[log pi_{theta}(a|s)(Q(s,a)-b)]\ &=-iintpi_{theta_{old} }log pi_theta(a|s)(Q(s,a)-b)~dsda end{aligned}
L=−Es∼ρπθold,a∼πθold[logπθ(a∣s)(Q(s,a)−b)]=−∬πθoldlogπθ(a∣s)(Q(s,a)−b) dsda
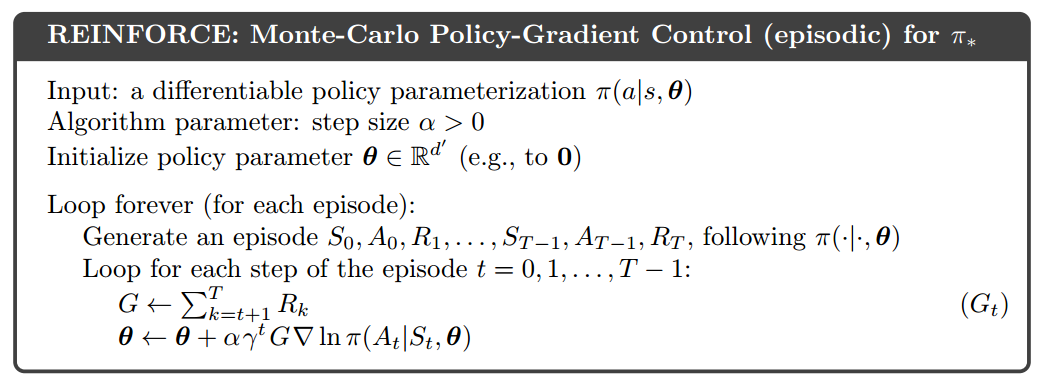
上式可以看做是新老策略分布的交叉熵乘上累积回报值。可以通过最小化上述损失函数求解。下面是《Reinforcement Learning: An Introduction》书中的算法,细节上可能有点出入
最后
以上就是合适草莓最近收集整理的关于【强化学习】随机策略梯度算法(stochastic-policy-gradient)的全部内容,更多相关【强化学习】随机策略梯度算法(stochastic-policy-gradient)内容请搜索靠谱客的其他文章。
发表评论 取消回复