目录
Hadoop生态圈
数据流程概述
1.数据采集主要技术
2.数据处理主要技术
3.数据存储技术
行式存储VS列式存储
SQL on Hadoop 调优
1.架构调优
2.语法调优
3.执行调优
Hadoop生态圈
数据流程概述
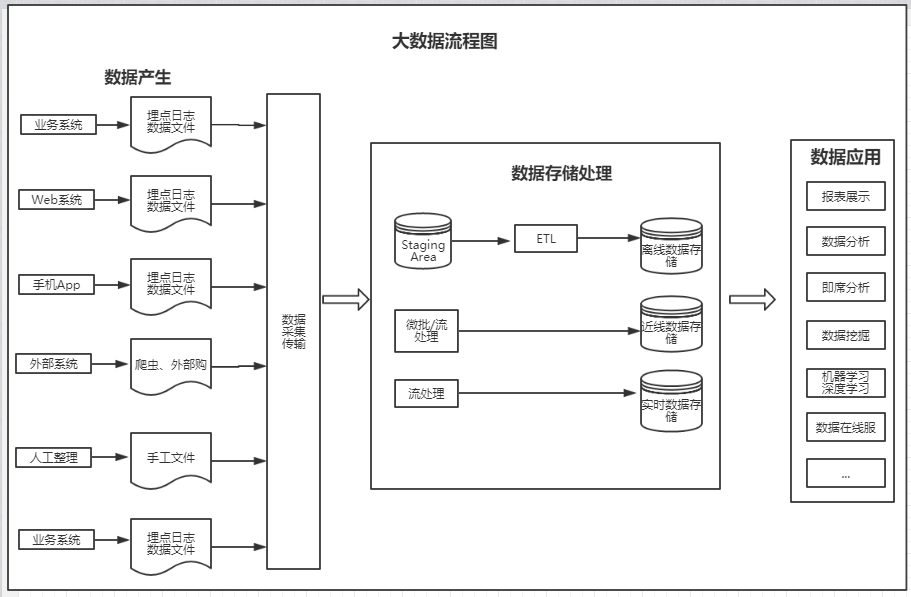
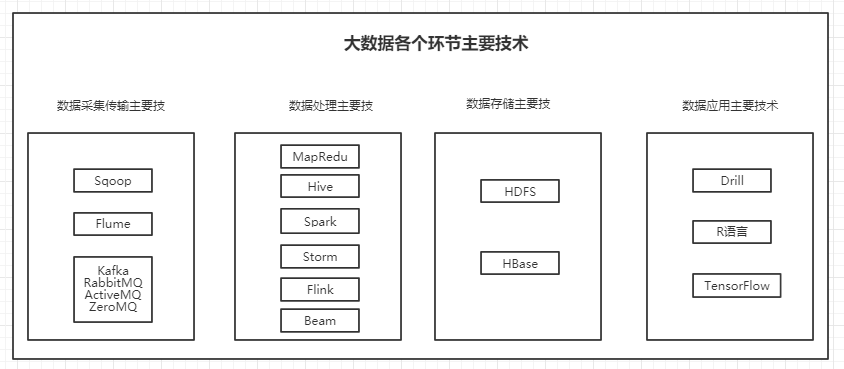
1.数据采集主要技术
Sqoop:是SQL-to-Hadoop的缩写,主要用于在Hadoop与关系型数据库之间交换数据,通过sqoop可以方便的将数据从MySql、Oracle等关系型数据库导入HDFS、HBase或Hive中,或者反过来。Sqoop主要通过JDBC与关系型数据库交互。
Flume:是Cloudera提供的一个高可用、高可靠、分布式的日志采集、聚合、传输的框架。Flume提供对数据进行简单处理并且写入各种数据接收方的能力。
Kafka:通常来说Flume采集数据的速度和下游处理的速度通常不同步,因此实时平台架构都会用一个消息中间件来缓冲,而这方面最为流行和应用最为广泛的无疑是Kafka。它是由LinkedIn开发的一个分布式消息系统,目前主流的开源分布式处理系统(如Storm和Spark等)都支持与Kafka 集成。Kafka是一个基于分布式的消息发布-订阅系统,特点是速度快、可扩展且持久。与其他消息发布-订阅系统类似,Kafka可在主题中保存消息的信息。生产者向主题写入数据,消费者从主题中读取数据。作为一个分布式的、分区的、低延迟的、冗余的日志提交服务。和Kafka类似消息中间件开源产品还包括RabbiMQ、ActiveMQ、ZeroMQ等。
2.数据处理主要技术
MapReduce:它是一种编程模型,用于大规模数据集(大于1TB)的并行计算。
Hive:是一个机遇Hadoop的数据仓库工具,可用于对Hadoop文件中的数据及进行数据整理、特殊查询和分析存储。Hive SQL实际上先被SQL解析器解析,然后被Hive框架解析成一个MapReduce可执行计划,并按照该计划生产MapReduce任务后交给Hadoop集群处理。适合做数据仓库的统计分析。
Spark:MapReduce和Hive数据处理延迟太高,比较适合做离线计算,不适合迭代计算、DAG(有限无环图)计算和实时计算。Spark具有可伸缩、基于内存计算能特点,可以直接读写Hadoop上任何格式的数据。Spark的作业中间结果可以保存在内存中,不需要读写HDFS,因此能更好适用于数据挖掘和机器学习等需要迭代的MapReduce算法。
Spark也提供类Live的SQL接口,即Spark SQL,来方便数据人员处理和分析数据。
Spark还有用于处理实时数据的流计算框架Spark Streaming,其基本原理是将实时流数据分成小的时间片段(秒或几百毫秒),以类似Spark离线批处理的方式来处理这小部分数据。
Storm:MapReduce、Hive和Spark是离线和准实时数据处理的主要工具,而Storm是实时处理数据的。Storm集群表面上和Hadoop集群非常像,但是在Hadoop上面运行的是MapReduce的Job,而在Storm上面运行的是Topology(拓扑)。Storm拓扑任务和Hadoop MapReduce任务一个非常关键的区别在于:1个MapReduce Job最终会结束,而1一个Topology永远运行(除非显示的杀掉它,),所以实际上Storm等实时任务的资源使用相比MapReduce任务等要大很多,因为离线任务运行完就释放掉所使用的计算、内存等资源,而Storm等实时任务必须一直占有直到被显式的杀掉。Storm具有低延迟、分布式、可扩展、高容错等特性,可以保证消息不丢失,目前Storm, 类Storm或基于Storm抽象的框架技术是实时处理、流处理领域主要采用的技术。
Flink:在数据处理领域,Storm只支持流处理任务,而MapReduce, Hive只支持批处理任务。Flink是一个同时面向分布式实时流处理和批量数据处理的开源数据平台,它能基于同一个Flink运行时(Flink Runtime),提供支持流处理和批处理两种类型应用的功能。Flink完全支持流处理,批处理被作为一种特殊的流处理,只是它的数据流被定义为有界的而已。Flink分别提供了流处理和批处理API,而这两种API也是实现上层面向流处理、批处理类型应用框架的基础。
Beam:Google开源的Beam在Flink基础上更进了一步,不但希望统一批处理和流处理,而且希望统一大数据处理范式和标准。Apache Beam项目重点在于数据处理的的编程范式和接口定义,并不涉及具体执行引擎的实现。Apache Beam希望基于Beam开发的数据处理程序可以执行在任意的分布式计算引擎上。
3.数据存储技术
HDFS:Hadoop Distributed File System,简称FDFS,是一个分布式文件系统。它有一定高度的容错性和高吞吐量的数据访问,非常适合大规模数据集上的应用。HDFS提供了一个高容错性和高吞吐量的海量数据存储解决方案。
HBase:HBase是一种构建在HDFS之上的分布式、面向列族的存储系统。在需要实时读写并随机访问超大规模数据集等场景下,HBase目前是市场上主流的技术选择。
HBase 不是关系型数据库,也不支持SQL,它的特性如下:
1、大:一个表可以有上亿上,上百万列。
2、面向列:面向列表(簇)的存储和权限控制,列(簇)独立检索。
3、稀疏:为空(null)的列不占用存储空间,因此表可以设计的非常稀疏。
4、无模式::每一行都有一个可以排序的主键和任意多的列。列可以根据需求动态增加,同一张表中不同的行可以有截然不同的列。
5、数据多版本:每个单元的数据可以有多个版本,默认情况下,版本号字段分开,它是单元格插入时的时间戳。
6、数据类型单一:HBase中数据都是字符串,没有类型。
行式存储VS列式存储
列式存储(column-based)是相对于传统关系型数据库的行式存储(Row-basedstorage)来说的。
优缺点:
1)行存储的写入是一次性完成,消耗的时间比列存储少,并且能够保证数据的完整性,缺点是数据读取过程中会产生冗余数据,如果只有少量数据,此影响可以忽略;数量大可能会影响到数据的处理效率。
2)列存储在写入效率、保证数据完整性上都不如行存储,它的优势是在读取过程,不会产生冗余数据,这对数据完整性要求不高的大数据处理领域,比如互联网,犹为重要。
SQL on Hadoop 调优
目的:在资源不变的前提下,让作业的执行性能有提升。两大类:CPU负载/IO负载。
1.架构调优
(1)Hive 分区表 partition:是指按照数据表的某列或某些列分为多个区,区从形式上可以理解为文件夹。数据表的内容巨大,在查询时进行全表扫描耗费的资源非常多。这这个情况下,我们可以按照例如日期之类的列对数据表进行分区,不同日期的数据存放在不同的分区,在查询时只要指定分区字段的值就可以直接从该分区查找。
(2)Hive 分桶表:分桶是相对分区进行更细粒度的划分。分桶将整个数据内容安装某列属性值得hash值进行区分,如要安装name属性分为3个桶,就是对name属性值的hash值对3取摸,按照取模结果对数据分桶。如取模结果为0的数据记录存放到一个文件,取模为1的数据存放到一个文件,取模为2的数据存放到一个文件。
(3)充分利用中间结果集:
比如:
select a,b,c from xxx where ...;

select a,c from xxx where ...;

select a,d from xxx where ...;
XXX数据集使用了3次,每次都要对xxx表进行全表检索,非常耗费资源。
考虑充分利用中间数据集:
create table xx_temp as select a,b,c,d from xxx where ...;

select a,b,c from xx_temp;

select a,c from xx_temp;

select a,d from xx_temp;
显然,xx_temp的数据量比xxx小得多,可以降低IO负载,性能得到优化。
(4)使用压缩:压缩技术能够有效减少底层存储系统(HDFS)读写字节数,提高网络带宽和磁盘空间的效率,减小IO负载。但需要注意的是,压缩与解压操作会需要额外的CPU开销,虽然这种开销并不大,但运用不当也可能降低性能。
一般情况下:
- 运算密集型的job,少用压缩
- IO密集型的job,多用压缩
| 压缩格式 | hadoop自带? | 算法 | 文件扩展名 | 是否可切分 | 换成压缩格式后,原来的程序是否需要修改 |
| DEFAULT | 是,直接使用 | DEFAULT | .default | 否 | 和文本处理一样,不需要修改 |
| Gzip | 是,直接使用 | DEFAULT | .gz | 否 | 和文本处理一样,不需要修改 |
| bzip2 | 是,直接使用 | bzip2 | .bz2 | 是 | 和文本处理一样,不需要修改 |
| LZO | 否(低版本),需要安装 | LZO | .lzo | 是 | 需要建索引,还需要指定输入格式 |
| Snappy | 否(低版本),需要安装 | Snappy | .snappy | 否 | 和文本处理一样,不需要修改 |
在选取压缩方式时,要考虑是否能切分、压缩比等因素。
压缩性能比较:
| 压缩算法 | 原始文件大小 | 压缩文件大小 | 压缩速度 | 解压速度 |
| gzip | 8.3GB | 1.8GB | 17.5MB/s | 58MB/s |
| bzip2 | 8.3GB | 1.1GB | 2.4MB/s | 9.5MB/s |
| LZO | 8.3GB | 2.9GB | 49.3MB/s | 74.6MB/s |
2.语法调优
(1)排序(主要是HIVE)
Hive基于HADOOP来执行分布式程序的,和普通单机程序不同的一个特点就是最终的数据会产生多个子文件,每个reducer节点都会处理partition给自己的那份数据产生结果文件,这导致了在HADOOP环境下很难对数据进行全局排序,如果在HADOOP上进行order by全排序,会导致所有的数据集中在一台reducer节点上,然后进行排序,这样很可能会超过单个节点的磁盘和内存存储能力导致任务失败。
-
order by 只有一个reduce负责对所有的数据进行排序,若大数据量,则需要较长的时间。建议在小的数据集中使用order by 进行排序。
-
order by 可以通过设置hive.mapred.mode参数控制执行方式,若选择strict,则order by 则需要指定limit(若有分区还有指定哪个分区) ;若为nostrict,则与关系型数据库差不多。
-
sort by 基本上不受hive.mapred.mode影响,可以通过mapred.reduce.task 指定reduce个数,查询后的数据被分发到相关的reduce中。
-
sort by 的数据在进入reduce前就完成排序,如果要使用sort by 是行排序,并且设置map.reduce.tasks>1,则sort by 才能保证每个reducer输出有序,不能保证全局数据有序。
-
distribute by 采集hash算法,在map端将查询的结果中hash值相同的结果分发到对应的reduce文件中。
-
distribute by 可以使用length方法会根据string类型的长度划分到不同的reduce中,最终输出到不同的文件中。 length 是内建函数,也可以指定其他的函数或这使用自定义函数。
-
cluster by 除了distribute by 的功能外,还会对该字段进行排序,所以cluster by = distribute by +sort by 。
(2)控制输出(reduce/partition/task)的数量:一个参数来设置,为什么要设置reduce的个数:决定了数据输出落地的文件的个数
-
reduce很多:小文件很多,并且reduce的创建和结束也会产生开销。
-
reduce很少:导致数据倾斜
(3)普通join/map join:Hive里默认的不是普通的join而是map join
普通的join也叫shuffle join相当于reduce join,真正的join是在reduce端完成的。
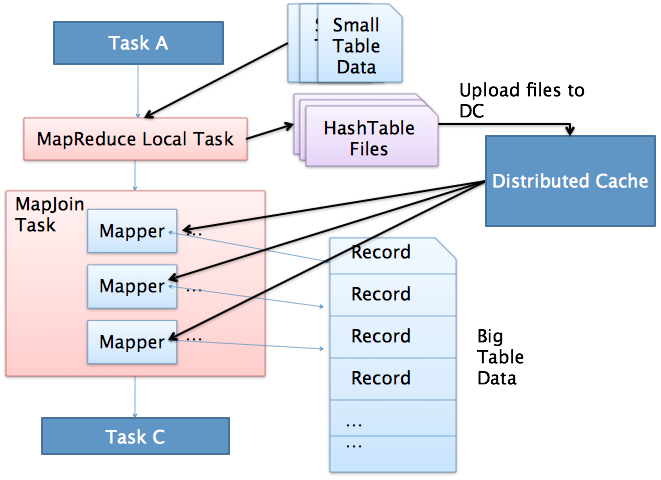
map join不经过shuffle,它会把小表加载到缓存中,通过mapper去读取大表数据,在读取大表数据时,和缓存中的小表数据直接对比,然后连接上。
mapreduce local task会去读小表数据,生成HashTable files,将其放入hadoop的distributed cache,然后maptask去读大表数据,没有shuffle,所以没有reduce。要设置 hive.auto.convert.join=true。
总结
-
mapjoin可以加快处理效率,但是这样如果数据量过大,加载到内存有可能会引起OOM(内存耗尽Out Of Memory)。
-
普通join 会产生shuffle,会影响效率(数据传输),也可能产生数据倾斜(一个key太多,那任务处理就会很慢)
3.执行调优
推测执行:是指在集群环境下运行MapReduce,可能是程序Bug,负载不均或者其他的一些问题,导致在一个JOB下的多个TASK速度不一致,比如有的任务已经完成,但是有些任务可能只跑了10%,根据木桶原理,这些任务将成为整个JOB的短板,如果集群启动了推测执行,这时为了最大限度的提高短板,Hadoop会为该task启动备份任务,让speculative task与原始task同时处理一份数据,哪个先运行完,则将谁的结果作为最终结果,并且在运行完成后Kill掉另外一个任务。推测执行是通过利用更多的资源来换取时间的一种优化策略,但是在资源很紧张的情况下,推测执行也不一定能带来时间上的优化。在资源本身就不够的情况下,还要跑推测执行的任务,这样会导致后续启动的任务无法获取到资源,以导致无法执行。
并行执行:前提要求多个task之间不存在依赖。使用参数设置,默认是关闭的,建议打开,默认并行任务数8。
JVM重用:Maptask和raducetask都是以进程方式进行,有多少个task就会启动多少个JVM,当task运行完毕,jvm会被销毁。设置JVM重用,可以使得JVM执行完一个TASK,不会销毁,继续执行下一个TASK,节省资源。也可以通过JVM重用解决小文件job过多的问题。
最后
以上就是冷艳金针菇最近收集整理的关于大数据面试(二)之常见SQL on Hadoop生态圈Hadoop生态圈的全部内容,更多相关大数据面试(二)之常见SQL内容请搜索靠谱客的其他文章。
发表评论 取消回复